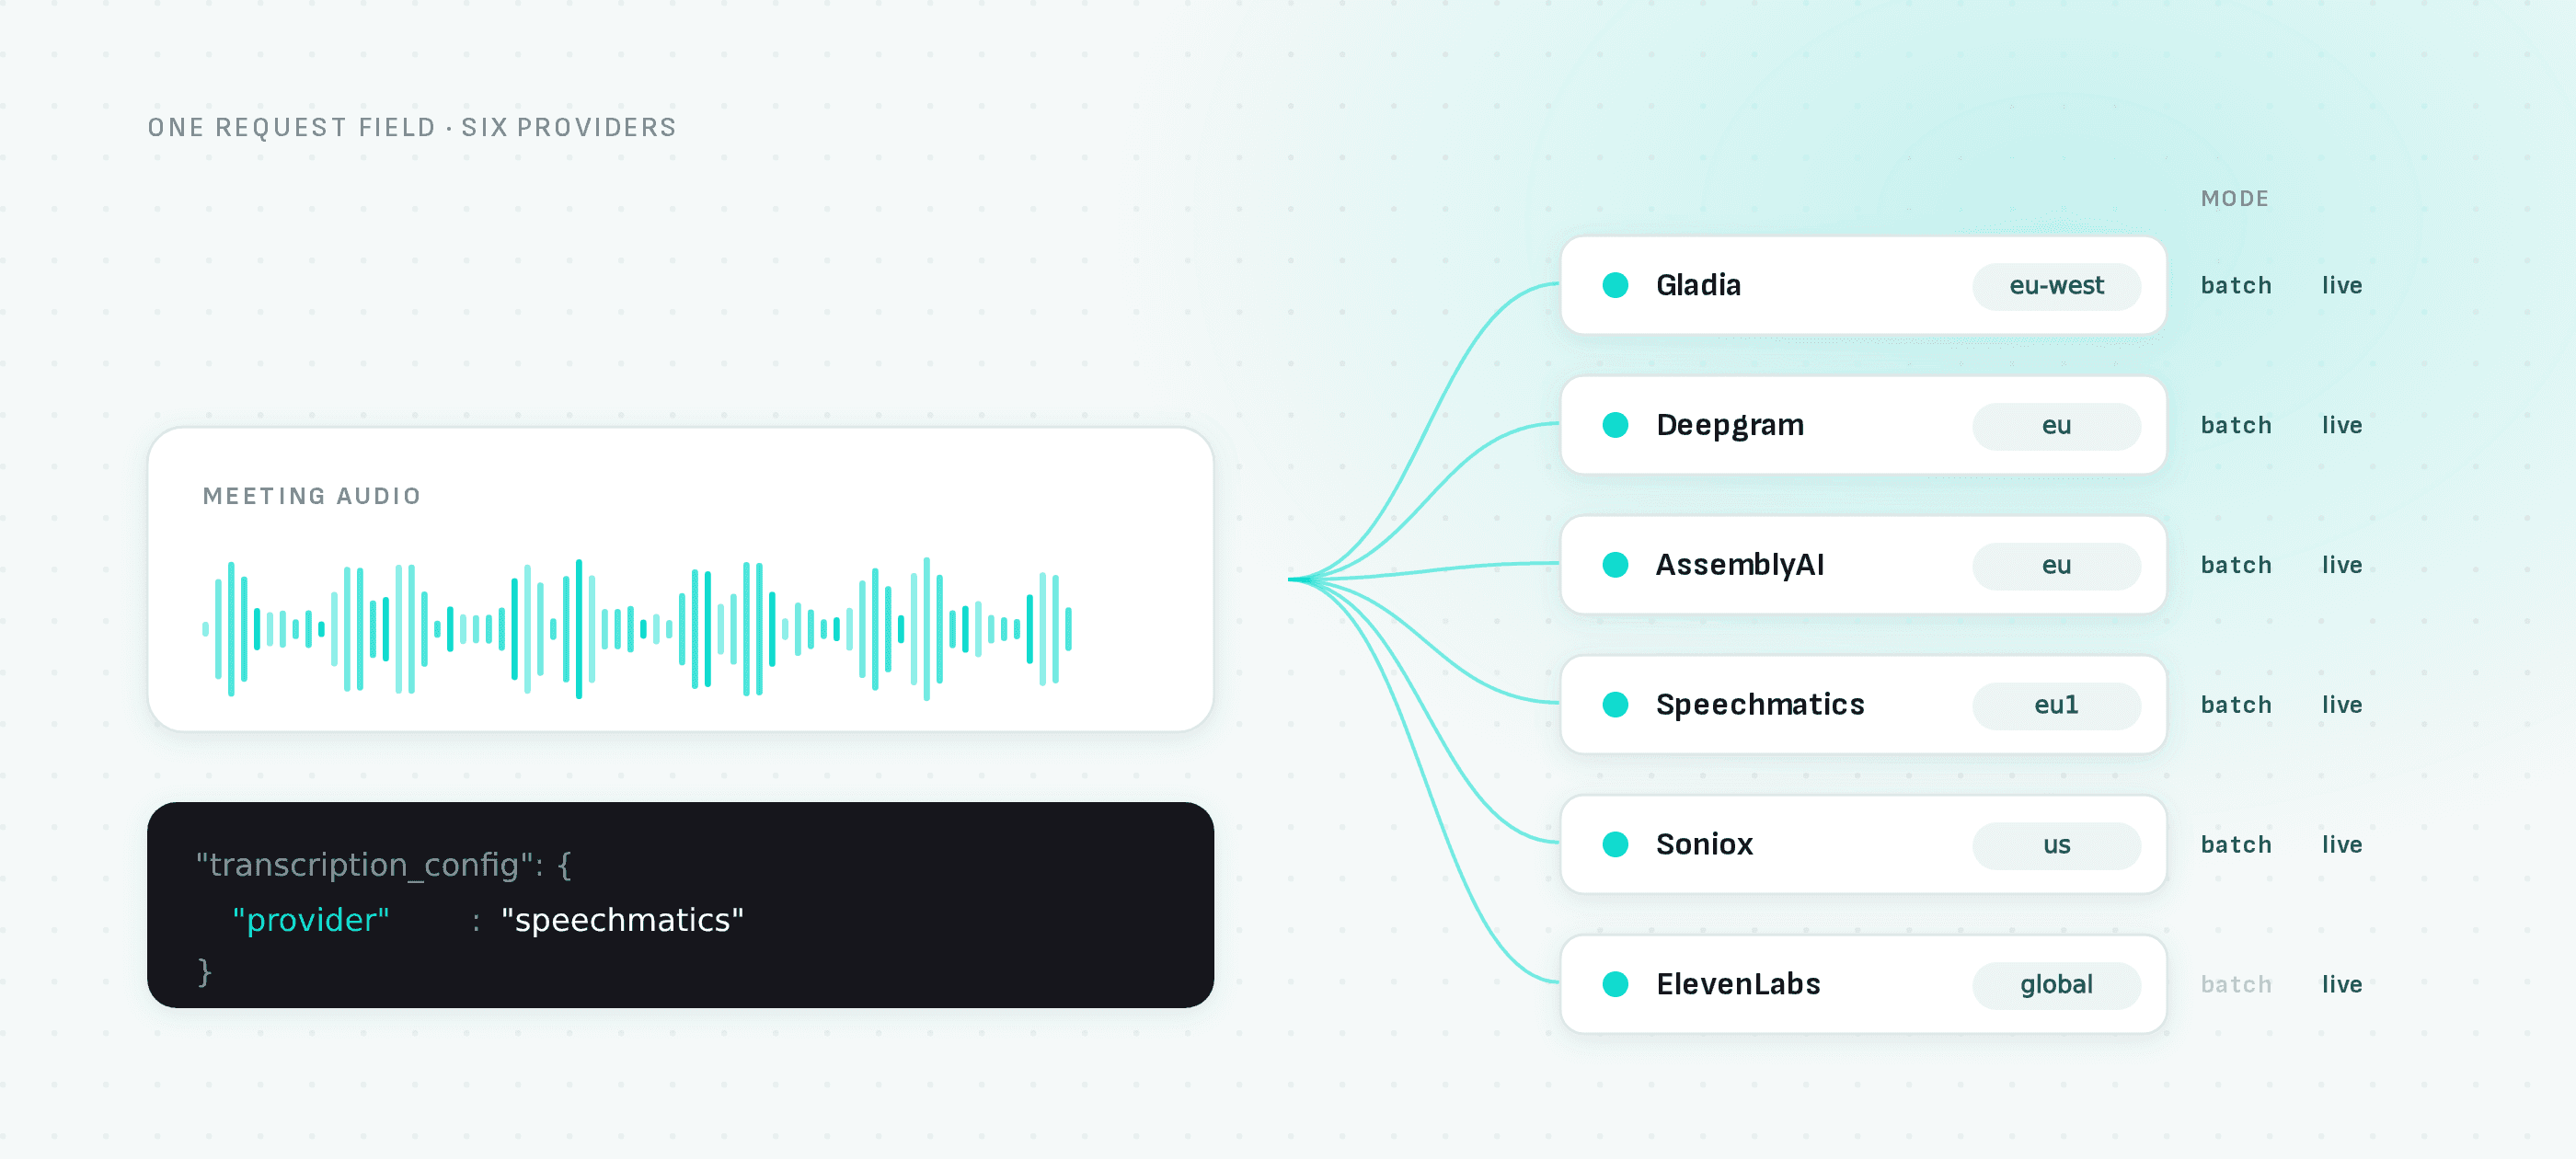
Gladia、Deepgram、AssemblyAI、Speechmatics、Soniox 和 ElevenLabs,按 bot 逐个选择,可以用你自己的 API key、你自己的区域,并完整透传各家专有的所有选项。
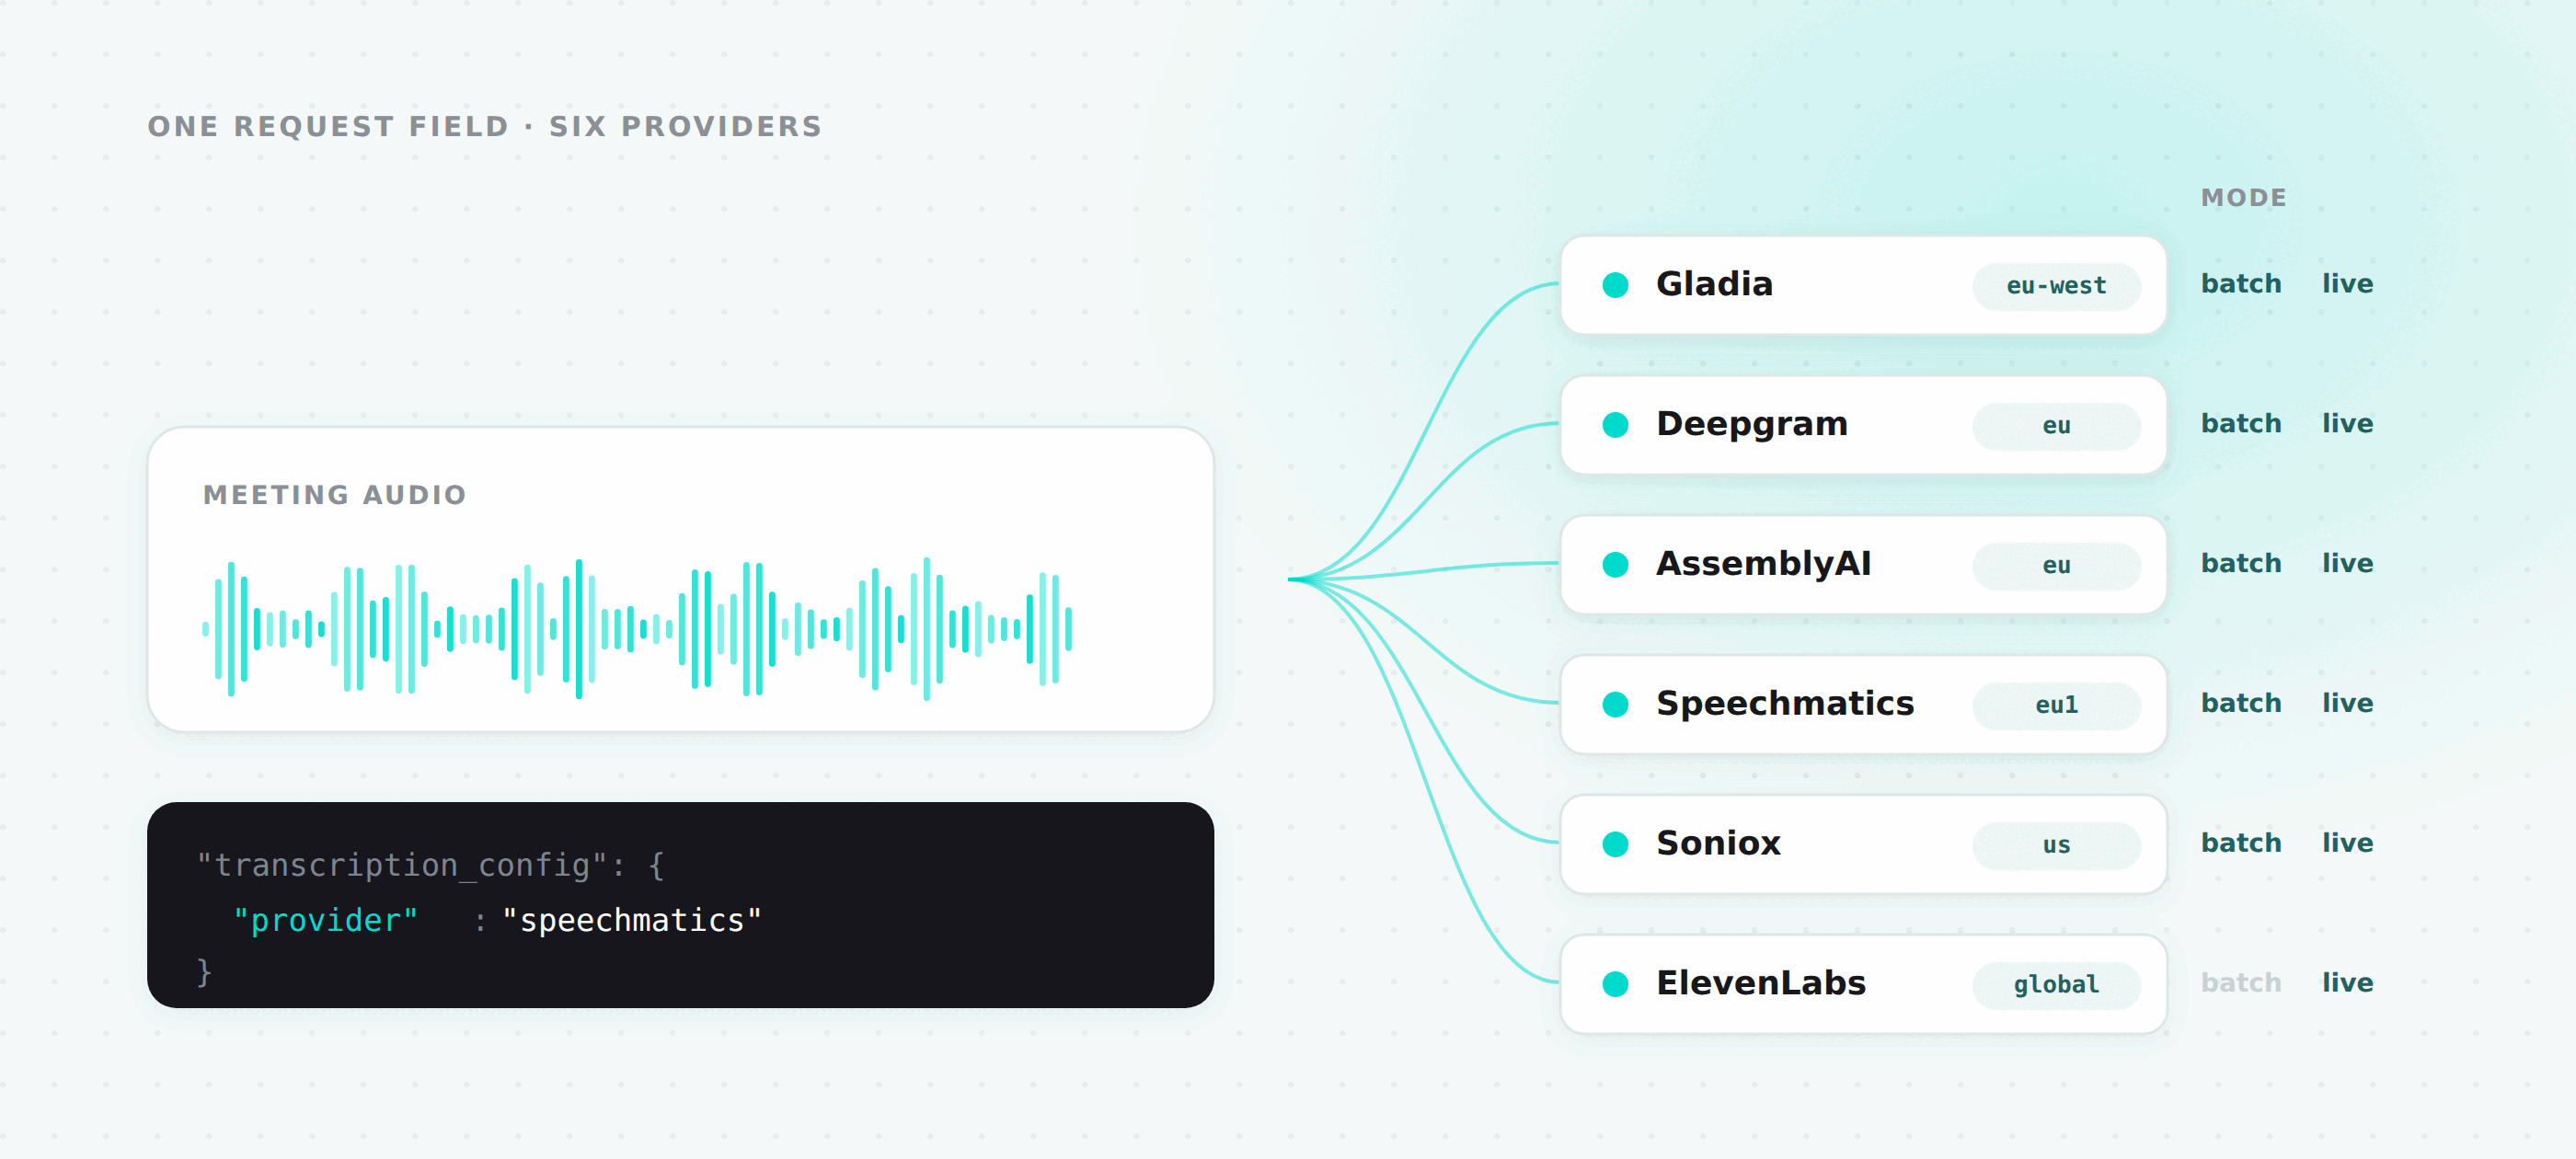
选一家语音转文字服务商,从来不是一锤定音的决定。在你所处领域的准确率、每小时的价格、你需要的语言、供应商愿不愿意签数据保留在欧盟的 DPA,以及三个人同时说话时说话人分离还撑不撑得住,这些都在变,而且没有哪个答案对所有客户都成立。
所以我们干脆不替你选了。你按 bot 逐个选择服务商,而且对已经录好的内容也可以改主意。
有哪些可选
| 服务商 | 批量 | 实时 |
|---|---|---|
gladia | ✅ | ✅ |
deepgram | ✅ | ✅ |
assemblyai | ✅ | ✅ |
speechmatics | ✅ | ✅ |
soniox | ✅ | ✅ |
elevenlabs | — | ✅ |
ElevenLabs 只支持流式。其余五家两种都支持。
大多数人要的是批量:会议结束,音频提交上去,一个 webhook 把带说话人标签和词级时间戳的转写文本送回来。实时则是会议还在进行时,转写片段就通过 WebSocket 不断到达,适合任何需要在会议现场作出反应的场景。
两者是各自独立配置的。如果你想要一路快速的实时输出,加上一份更准确的最终转写文本,可以在同一个 bot 上同时启用,并分别用不同的服务商。
批量
{
  "meeting_url": "https://meet.google.com/abc-defg-hij",
  "bot_name": "Recording Bot",
  "transcription_enabled": true,
  "transcription_config": {
    "provider": "speechmatics",
    "region": "eu2",
    "api_key": null,
    "custom_params": null
  }
}一共四个字段。provider 省略时默认为 "gladia"。region、api_key 和 custom_params 默认都是 null,下面会分别讲到。
当 transcription_enabled 为 true 时必须提供 transcription_config;为 false 时它会被忽略。
bot 结束后,transcription_provider 和 transcription_ids 会出现在 bot 记录和 webhook payload 中,GET /v2/bots/:bot_id/status 会报告直接从服务商轮询来的实时 transcription_status:not-applicable、not-started、queued、processing、done 或 error。
区域绑定
这些服务商大多在多个区域运行,而对我们很多客户来说,这才是全部关键。
| 服务商 | 批量区域 | 实时区域 |
|---|---|---|
gladia | 仅全局 endpoint | us-west、eu-west |
deepgram | global、eu | global、eu |
assemblyai | us、eu | us、eu |
speechmatics | eu1、eu2、us1、us2、au1 | 同左 |
soniox | us、eu、jp | 同左 |
elevenlabs | — | global、us、eu、in |
如果你传了某家服务商没有的区域,创建 bot 时就会拿到 400,并附上允许的取值,而不是等到后面才发现问题。Gladia 的批量 API 只有全局一个,所以在批量配置里对 provider: "gladia" 传 region 会被拒绝。它的实时 API 确实有区域之分。
把 region 留空,我们会选一个合理的默认值:Deepgram 和 AssemblyAI 用 eu,Speechmatics 用 eu1,Soniox 用 us。
如果你需要音频绝不离开某个司法辖区,请把这项和自带存储搭配使用。服务商是从 bucket 上的签名 URL 拉取音频的,所以 bucket 的位置和服务商的区域共同决定了音频实际会去哪里。
自带 key
传入 api_key,我们就用你在该服务商的账户,而不是我们的。
{
  "transcription_config": {
    "provider": "deepgram",
    "region": "eu",
    "api_key": "your-deepgram-key"
  }
}
key 在存储前会用 AES-256-GCM 加密,传输到 bot 的过程中也保持加密,由 bot 在使用的那一刻解密。当你删除某个 bot 的数据时,存储的 key 会被覆写。
用它有两个理由。第一是成本:使用我们的 key 做转写按每小时 0.25 token 计费,用你自己的则是 0.05。第二是有些事只有在你自己的账户上才能做到,比如你训练过的自定义词表,或者一份我们没有的合同条款。
BYOK 面向 Pro 及以上套餐。没有这个权限会返回 FST_ERR_BYOK_TRANSCRIPTION_NOT_ENABLED_ON_PLAN。
服务商选项,原样透传
我们刻意没有做一层归一化的选项抽象。每家服务商都有别家没有的功能,把它们压平到最大公约数,等于丢掉了你选择这家服务商的理由。
custom_params 基本上会按你写的样子直接交给服务商:
{
  "transcription_config": {
    "provider": "speechmatics",
    "region": "eu2",
    "custom_params": {
      "transcription_config": {
        "language": "en",
        "diarization": "speaker",
        "operating_point": "enhanced"
      }
    }
  }
}
如果点号写法更方便构造,它同样可用:
{ "custom_params": { "diarization_config.min_speakers": 2 } }在实时配置里,点号写法会先展开再校验,所以你校验的就是服务商真正会收到的结构。在批量配置里,扁平的键会按写下的样子校验,等到提交时再展开。
在实时配置中,有四个字段由 pipeline 设定,你传了会被拒绝:encoding、sample_rate、bit_depth、channels。尤其是采样率,它是根据会议音频按各家服务商协商出来的,覆盖它会破坏整条流。请改用 streaming_config.audio_frequency。
说话人分离默认开启,因为不开你拿到的就是一整片没有说话人标签的文字,而且至少有一家服务商在你不主动要求时会静默地一句话都不返回。custom_params 中的显式取值优先。
一个坑:批量和实时的结构不一样
这件事会让人白白搭进去一个下午,所以值得直说。对同一家服务商,实时 API 和批量 API 接受的参数结构并不相同。
Gladia 是最清楚的例子。批量把翻译配置放在顶层。实时则要求它嵌套在 realtime_processing 下面:
{
  "streaming_config": {
    "mode": "transcription",
    "output_url": "wss://your-app.example.com/transcripts",
    "audio_frequency": 24000,
    "transcription": {
      "provider": "gladia",
      "region": "eu-west",
      "api_key": "your-gladia-key",
      "custom_params": {
        "language_config": { "languages": ["ru"] },
        "realtime_processing": {
          "translation": true,
          "translation_config": { "target_languages": ["en"] }
        }
      }
    }
  }
}
实时参数按严格模式校验,因为实时会话 API 会直接拒绝未知的键,而我们宁愿让你的 bot 创建失败,也不愿让你的会议失败。当你把本该低一层的键放到顶层时,错误信息会告诉你它该在哪:
'translation' is not a top-level field of the gladia live API —
did you mean 'realtime_processing.translation'?
(the live API shape differs from batch)
批量参数和实时参数都会在创建 bot 时按各家服务商自己的 schema 校验,所以一个拼写错误一秒钟就以 400 的形式返回,而不是一小时后变成一次失败的转写。关于严格程度有两点说明。批量解析是宽松的,未知的批量键会通过校验并被转发给服务商去处理;只有实时会拒绝未知的键。另外,ElevenLabs 的实时参数不做校验直接透传,因为它没有公开的 schema 供我们比对。
实时输出
在 mode: "transcription" 下,我们会开启服务商会话,把会议音频喂进去,并以 JSON 形式把事件转发到你的 output_url:
{
  "event": "transcript.segment",
  "bot_id": "a1b2c3d4-e5f6-7890-abcd-ef1234567890",
  "data": {
    "text": "so the migration lands Thursday",
    "isFinal": true,
    "utteranceStart": 12.44,
    "utteranceEnd": 14.91,
    "confidence": 0.97,
    "speaker": { "name": "Alice", "id": 1 },
    "words": []
  }
}
此外还有带上所用服务商的 session.started、你主动要求时才有的 translation,以及 error。我们每 30 秒 ping 一次,防止中间设备把空闲的 socket 关掉。
有一个限制:使用我们平台 key 的实时会话只能用一组托管的服务商,目前是 Gladia。用其他服务商做实时转写需要 BYOK key,我们会在创建 bot 时就用 FST_ERR_STREAMING_TRANSCRIPTION_KEY_UNAVAILABLE 拒绝,而不是等会议开始才发现。
改主意
POST /v2/bots/:bot_id/retranscribe{
"transcription": {
"provider": "assemblyai",
"region": "eu",
"api_key": "your-assemblyai-key"
}
}已存储的音频会重新提交给另一家服务商,bot 的配置也随之更新。你可以用这种方式在自己的会议上对两家供应商做 A/B 对比,而不是只听他们的演示音频;转写失败时也靠它来恢复。
删除某个 bot 的数据时,带上 ?delete_from_provider=true(默认值)也会把转写文本从服务商那边删掉,如果你提供了自己的 key,就用你的 key 来删。
当某家服务商状态不佳时
一次失败的提交会重试两次,分别在 5 秒和 15 秒后,总共三次尝试。只有重试确实可能奏效的错误才会进入重试:rate limit、5xx、连接和轮询超时、网络层故障,以及服务商返回了 2xx 但 body 里没有 job id 的情况。认证错误、输入无效和不支持的操作永远不会重试,因为第二次也会以同样的方式失败。
每次重试在重新提交前都会轮换 callback secret。这堵住了一个真实的竞态:如果服务商其实已经接受了那个 job,只是 response 在我们这边超时了,那么它的 callback 会带着一个已不存在的 secret 到达并被拒绝,而不会和重试的 job 抢跑,导致同一段音频产生两份转写文本。
我们不会自动切换到第二家服务商,这一点我宁愿直说,也不想让你在故障期间才发现。如果你选的服务商在重试之后仍然失败,bot 会以 failed 结束并带上 TRANSCRIPTION_FAILED,而录像和音频产物都还在。恢复方式是调用一次 retranscribe,可以顺便指定另一家服务商。静默切换供应商,意味着你的转写文本落在一个你没同意的司法辖区、按一个你没同意的价格计费,所以这个决定我们留给你。
相关阅读
- 自带存储 —— 控制服务商读取的音频究竟存放在哪里
- Meeting BaaS API 参考文档