Aponte a MeetingBaaS para um object storage que é seu e cada gravação, transcrição, trecho de áudio e log vai para lá. Duas credenciais, uma verificação de acesso de verdade e um relato honesto do que você abre mão.
"Onde fica a gravação?" é a pergunta que trava negociações enterprise. Para um banco, um hospital ou qualquer um que opere sob um requisito de residência de dados, "nos nossos buckets, criptografada" não é uma resposta que dê para levar ao time de compliance.
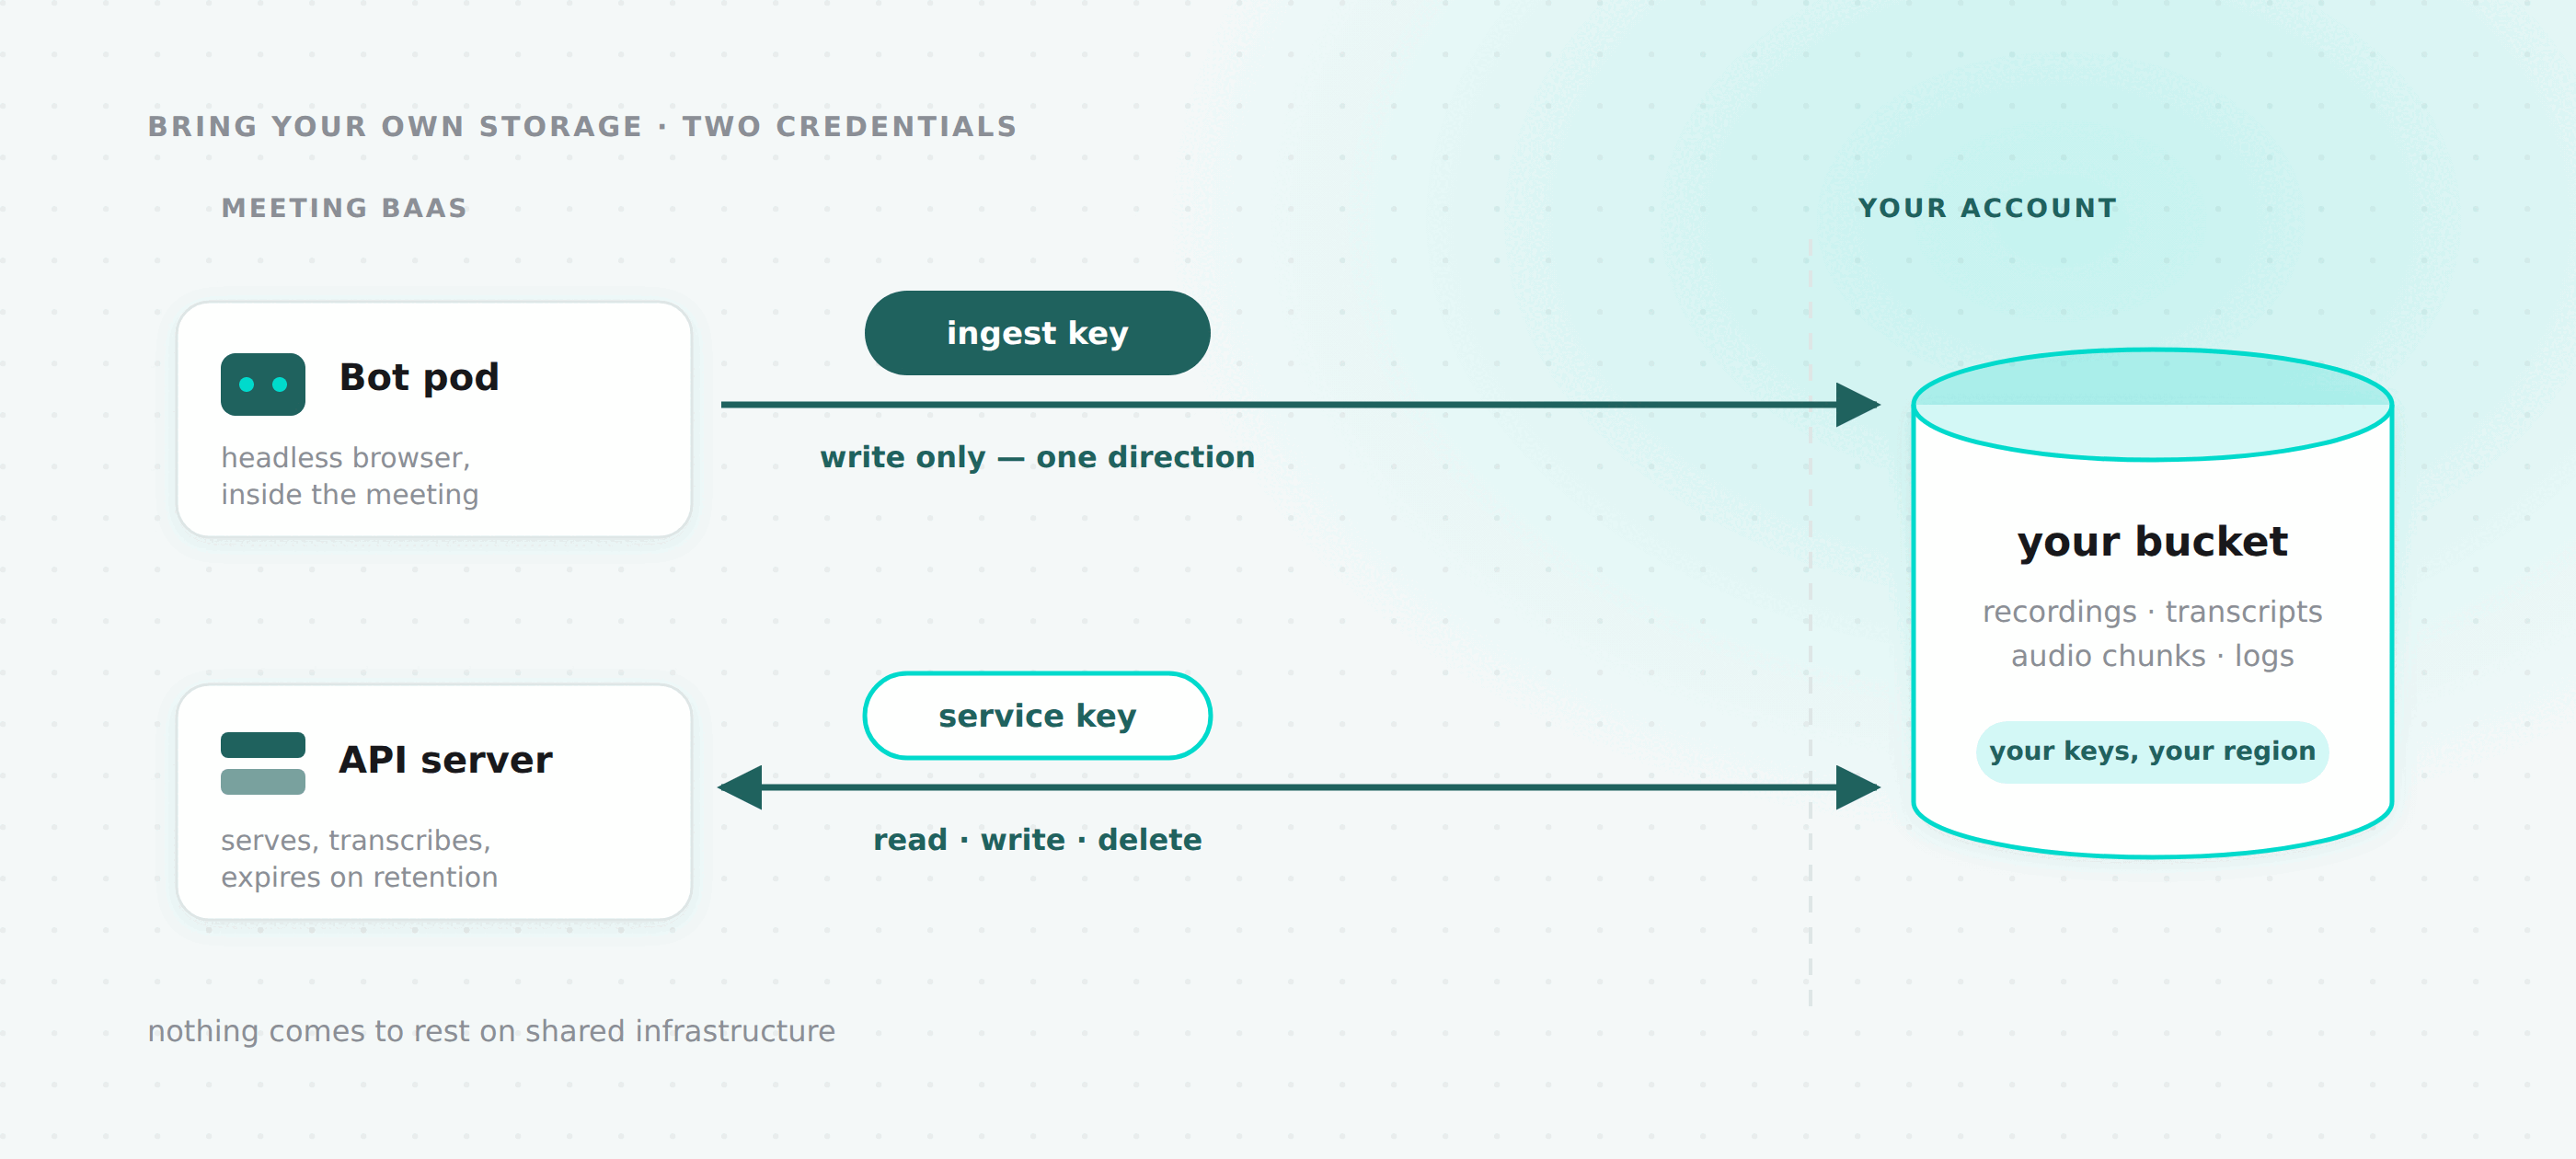
Então agora você pode nos dar um bucket. Todo artefato que os seus bots produzirem daquele momento em diante, gravações, trechos de áudio, transcrições, capturas de tela e logs, é gravado em um armazenamento que é seu, com credenciais que você emitiu e pode revogar.
GET    /v2/storage-config          your current configuration, 404 if unset
PUT    /v2/storage-config          set or replace it
POST   /v2/storage-config/test     re-run the access check
DELETE /v2/storage-config          back to MeetingBaaS storage
Ou Configurações (Settings) → Armazenamento (Storage) no dashboard, que são os mesmos quatro handlers atrás da autenticação de sessão.
Duas credenciais, separadas por onde elas fisicamente terminam
Essa é a decisão de design que eu defenderia com mais afinco, então deixa eu começar por ela.
Você fornece dois pares de chaves de acesso, não um:
| Permissões | Onde ela fica | |
|---|---|---|
| ingest | PutObject, PutObjectTagging, AbortMultipartUpload | Entregue ao bot de gravação. Sai da nossa rede. |
| service | GetObject, ListBucket, PutObject, DeleteObject | Só no nosso servidor de API. Nunca sai. |
A chave de ingest é a única credencial que chega perto da sua reunião. Ela vai parar em um pod rodando um navegador headless dentro de uma chamada, que é o lugar mais exposto em que qualquer credencial deste sistema poderia estar. Ela pode escrever objetos. Não pode ler nenhum de volta, não pode listar o que está lá e não pode excluir nada. Um pod comprometido consegue adicionar lixo a um prefixo, e isso é tudo.
A chave de service faz todo o resto: servir as suas gravações de volta por URLs assinadas, escrever as transcrições quando elas chegam e excluir artefatos quando a sua janela de retenção expira.
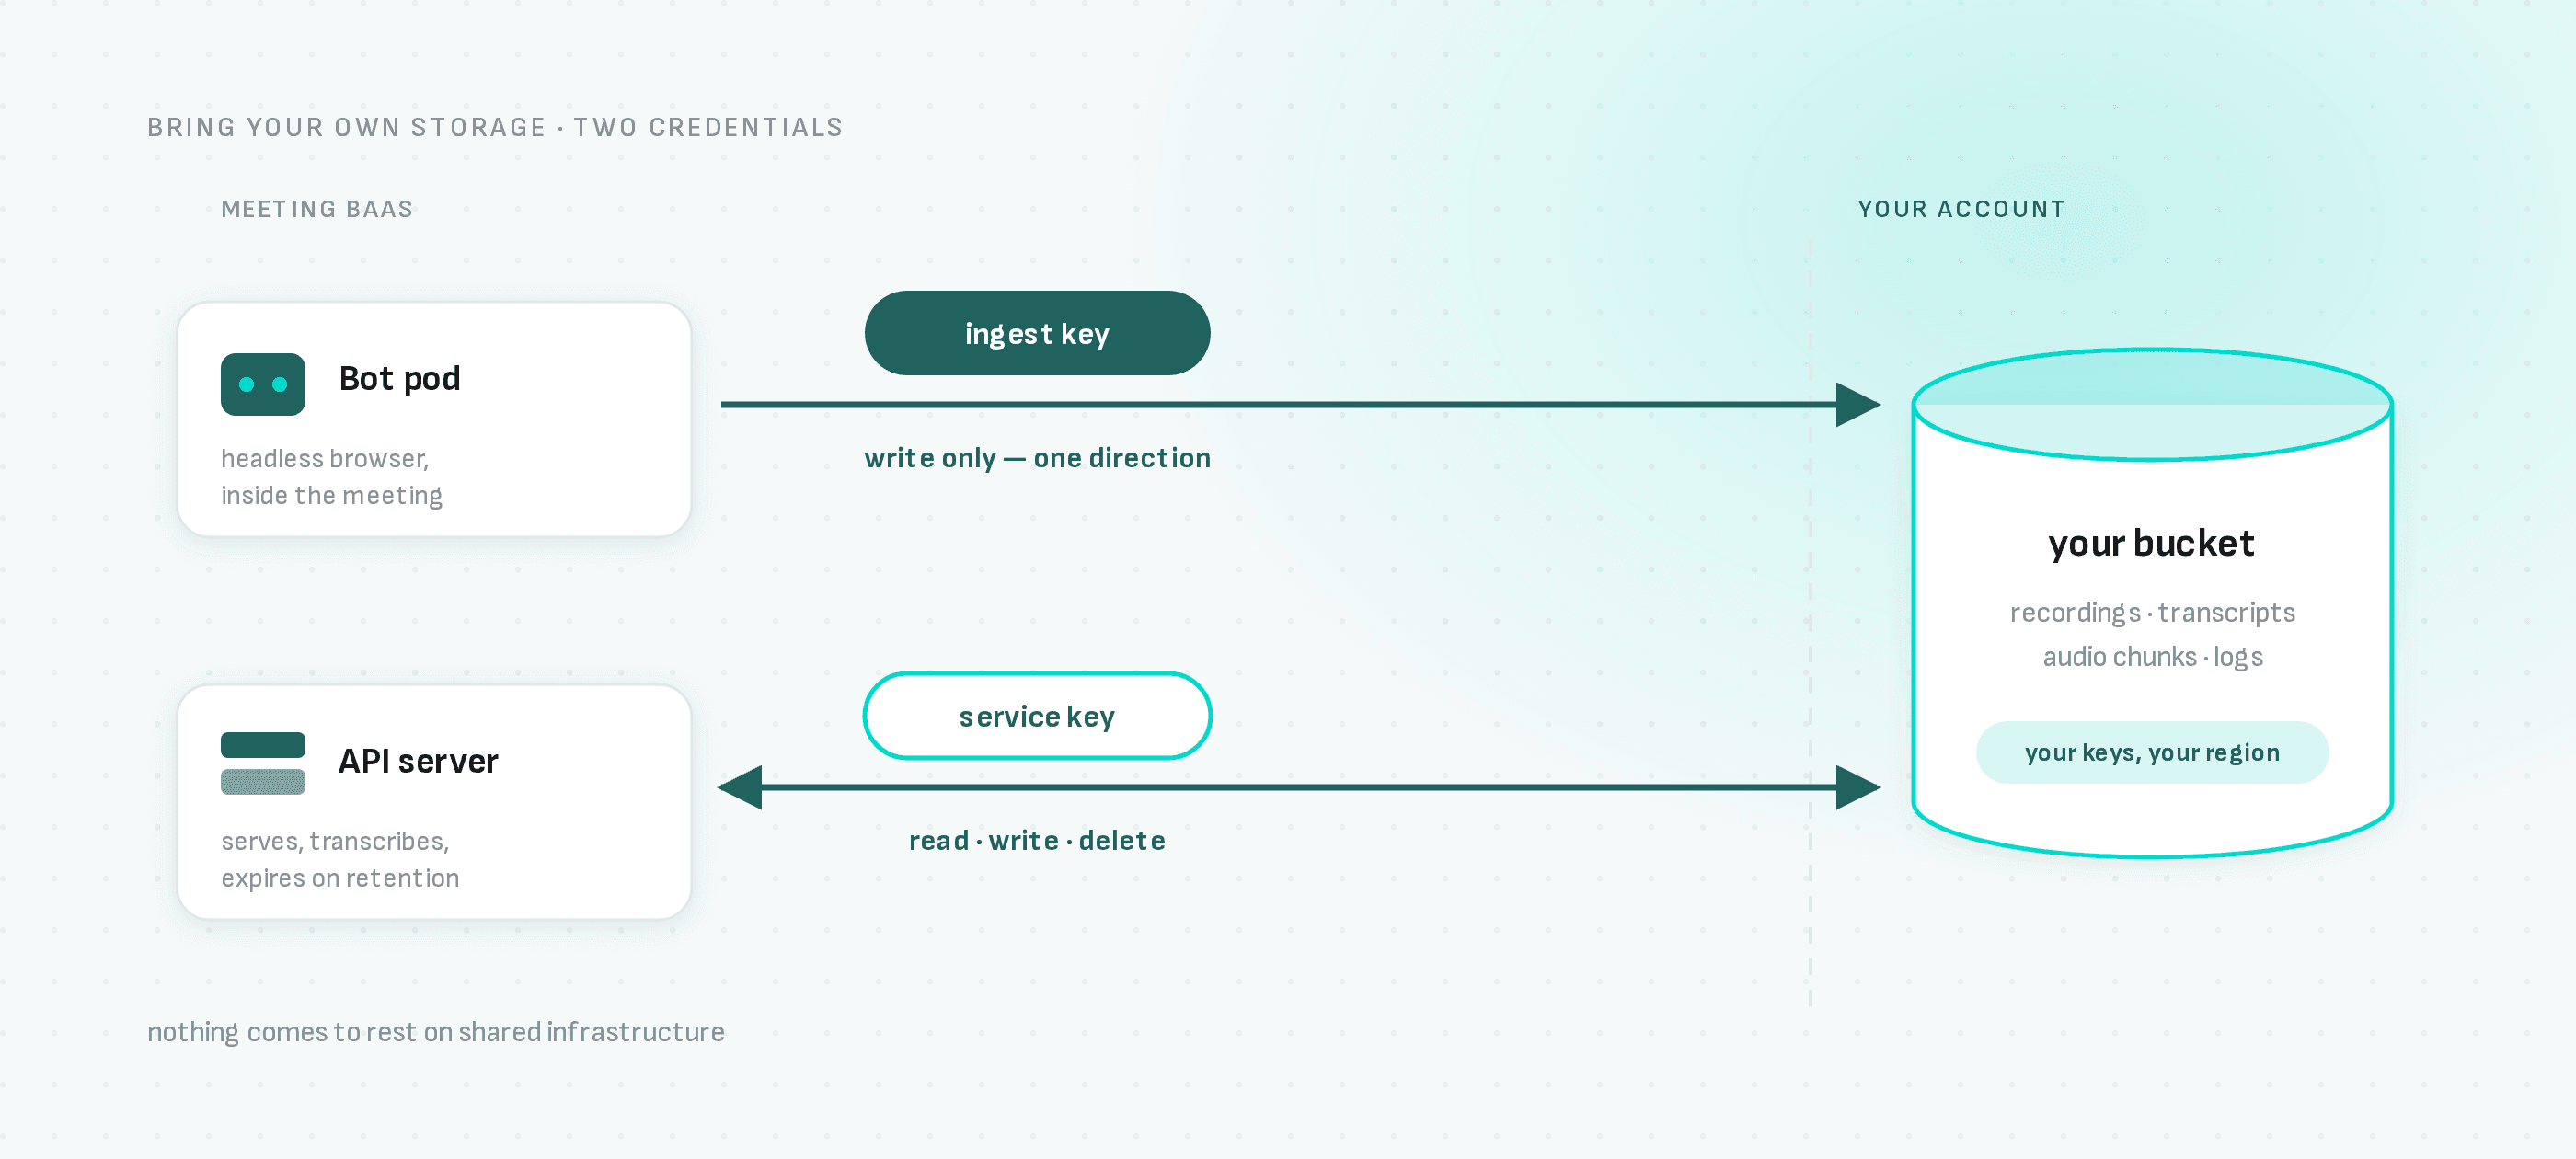
Vale ser preciso sobre uma coisa aqui. A chave de service não é somente leitura, e descrevê-la assim seria uma mentira na qual você acabaria nos pegando. Ela escreve e exclui, porque a API genuinamente faz as duas coisas. O que a separação compra é que a credencial no lugar arriscado é a fraca. Isso é uma redução real do raio de impacto e não é a mesma coisa que menor privilégio em todo canto, e prefiro te dizer exatamente qual dos dois você está levando.
Como configurar
{
  "endpoint": "https://s3.eu-west-3.amazonaws.com",
  "region": "eu-west-3",
  "force_path_style": false,
  "artifacts_bucket": "acme-meeting-artifacts",
  "audio_chunks_bucket": "acme-meeting-audio-chunks",
  "logs_bucket": "acme-meeting-logs",
  "allow_transient_spill": false,
  "ingest_access_key_id": "AKIAIOSFODNN7EXAMPLE",
  "ingest_secret_access_key": "...",
  "service_access_key_id": "AKIAI44QH8DHBEXAMPLE",
  "service_secret_access_key": "..."
}
Os três nomes de bucket podem ser todos o mesmo bucket. As chaves dos objetos são prefixadas com o id do bot de qualquer forma, então nada colide. force_path_style é o que MinIO, Ceph e a maioria dos gateways auto-hospedados precisam; AWS e Scaleway funcionam sem ele.
O endpoint precisa ser HTTPS público, sem credenciais nem query string nele. Os buckets devem ser privados, já que os artefatos são servidos por URLs assinadas de vida curta, mas eles precisam sim ser alcançáveis pela internet: os provedores de transcrição buscam o áudio diretamente de uma URL assinada, em vez de passar por nós.
Já que está por lá, libere a origem do dashboard no bucket de artefatos. O dashboard busca os artefatos e lê o JSON das transcrições em vez de apontar direto para eles, então são leituras cross-origin contra o seu endpoint, e sem uma regra de CORS o navegador descarta a resposta antes de qualquer coisa aparecer. GET e HEAD a partir da origem do seu dashboard é a regra inteira. Vale saber que PutBucketCors fica um degrau acima das permissões de objeto que a chave service tem, então exige uma credencial de nível owner — a chave service devolvendo Forbidden ali é o escopo funcionando, não um bug.
Ler a configuração de volta te dá os dois IDs de chave de acesso, para você saber quais credenciais estão em uso, e nenhum dos dois segredos. Nunca. Substituir uma configuração significa digitar os dois segredos de novo, porque não conseguimos te mostrar o que está lá.
A verificação de acesso, e por que ela não é formalidade
O PUT verifica a configuração antes de armazená-la. E não chamando ListBuckets e dando o assunto por encerrado.
A chave de ingest escreve um objeto marcador em cada bucket distinto. Depois a chave de service lê esse objeto, escreve nele e o exclui.
Cada verbo é exercitado pela credencial que vai realmente executá-lo em produção, então a sondagem falha do mesmo jeito que a produção falharia. Os quatro carregam peso: o upload de ingest é como as gravações chegam, o upload de service é como as transcrições são escritas, a leitura é como os artefatos são servidos, a exclusão é como a retenção de fato expira alguma coisa.
A parte genuinamente útil é separar escrita de leitura. O marcador é escrito por uma credencial e precisa ser encontrado pela outra. Isso pega a falha que ninguém testa: dois pares de chaves individualmente válidos, mas apontados para buckets diferentes ou contas diferentes. Toda verificação de saúde de credencial única do mundo passa nessa configuração, e aí você perde uma gravação.
Sem isso, o primeiro sinal de um nome de bucket digitado errado é um upload falho no fim de uma reunião real, depois que o disco local do pod já se foi. Quando a verificação falha, mostramos a mensagem do próprio provedor na íntegra em vez de um erro genérico, porque "a chave de ingest não consegue escrever no artifacts bucket" é o valor inteiro de rodar essa checagem.
Você pode rodá-la de novo quando quiser com POST /v2/storage-config/test, que é o que você quer depois de rotacionar chaves ou mudar uma política de bucket.
Uma coisa que ela deliberadamente não consegue pegar: CORS. A sonda roda a partir dos nossos servidores, onde CORS não se aplica, então um bucket pode passar em todos os verbos acima e mesmo assim se recusar a entregar uma gravação para um navegador. Essa lacuna é nossa para fechar e, até lá, a observação sobre liberar a origem do dashboard é o que separa um check verde de um dashboard que não mostra nada.
A invariante da qual todo o resto decorre
Um bot sempre resolve para o armazenamento em que ele foi escrito, nunca para aquele com que o time dele está configurado hoje.
Quando um bot é despachado, a configuração de armazenamento em vigor naquele instante é carimbada no registro do bot. Toda leitura, toda URL assinada e toda exclusão daquele bot resolvem pelo carimbo. Não pelo time.
Isso soa como um detalhe de implementação. É o motivo pelo qual o recurso é seguro de ligar, e quatro consequências decorrem diretamente disso:
Mudar a sua configuração insere uma nova linha e desativa a antiga. Nunca há atualização no lugar. Mutar a linha redirecionaria silenciosamente os artefatos de todo bot existente para um bucket onde eles não existem.
DELETE /v2/storage-config só vira uma flag. Nada é excluído, de nenhum dos lados. Uma exclusão de verdade tiraria as credenciais de que bots mais antigos ainda precisam e deixaria órfã cada gravação da sua conta.
A resolução deliberadamente ignora se uma configuração está habilitada. Desabilitar para de mandar artefatos novos para o seu bucket. Não pode deixar órfãos os que já estão lá.
Uma configuração carimbada que não pode ser encontrada gera um erro em vez de cair de volta nos nossos buckets. Cair de volta reportaria os seus artefatos como ausentes e, em uma exclusão por retenção, deixaria os seus dados para trás silenciosamente enquanto reportava sucesso. Falhar alto é o comportamento correto.
Na prática: configure, mude ou remova quando você quiser. Gravações antigas continuam funcionando durante tudo isso. A única coisa que torna artefatos antigos ilegíveis é revogar o nosso acesso do seu lado, o que é uma decisão sua e funciona exatamente como você esperaria.
A troca que você está de fato fazendo
allow_transient_spill é false por padrão para times no próprio armazenamento, o que é o oposto do padrão da nossa plataforma. Eis o que isso significa, na íntegra, porque é o único ponto em que este recurso te custa algo.
Normalmente, quando um upload falha, espelhamos o artefato no nosso próprio volume de rede e um job de reconciliação o envia depois. Esse caminho copia a reunião inteira: o vídeo, o áudio, a saída de diarização, cada trecho. Para a nossa infraestrutura, na nossa conta.
Que é exatamente o que um cliente de residência contratou para evitar. Pior, clientes de residência caem nesse caminho mais do que clientes de plataforma, porque o bucket deles está fora da nossa rede e muitas vezes em um provedor completamente diferente.
Então, com allow_transient_spill: false, o fallback é desligado em todo tipo de bot e no consumer. Um upload que esgota as tentativas é reportado como falho, e o artefato é perdido.
Essa é a troca: durabilidade por residência. Compensamos isso em parte dando ao cliente de upload do bot seis tentativas em vez das três padrão do SDK, de modo que uma instabilidade não te custe uma gravação, mas uma indisponibilidade prolongada do seu bucket ainda vai custar.
Defina como true se você prefere ficar com a gravação a manter a garantia. O dashboard mostra um aviso explicando com precisão do que você está abrindo mão quando muda isso, porque não deveria ser uma caixinha que se marca sem pensar.
Se gravações sumirem e o seu bucket teve uma indisponibilidade, é a primeira coisa a checar.
O que isso não faz
Quatro coisas, ditas de antemão para ninguém descobrir depois.
Nada que já foi gravado é movido. Não há migração. Todo bot continua resolvendo para onde ele foi escrito, que é o que torna seguro ligar isso, e também significa que o seu histórico fica nos nossos buckets.
Sem configuração de prefixo por bucket. As chaves são <bot_uuid>/… e isso é fixo.
Isso sozinho não torna a residência hermética. Os pods dos bots ainda mantêm a gravação em disco local enquanto a reunião acontece. O que isso fecha é o único caminho em que a sua gravação vem repousar em infraestrutura compartilhada da MeetingBaaS.
Os assets do dashboard continuam nos nossos buckets. Logos, avatares de usuário e anexos de suporte não são dados de reunião e não estão cobertos.
Voltando atrás
DELETE /v2/storage-config, seguro a qualquer momento. Bots novos voltam para o nosso armazenamento imediatamente. Bots existentes continuam resolvendo para os seus buckets e continuam funcionando.
Relacionados
- Seis Provedores de Transcrição, Uma Única API — combine a região de um bucket com a região de um provedor para residência de ponta a ponta
- Self-hosting do Meeting BaaS — se ser dono do bucket ainda não for longe o bastante
- Referência da API do Meeting BaaS
Se você está lidando com um requisito de residência e quer saber exatamente quais componentes tocam o quê, pergunte para a gente. Vamos te dar a mesma resposta que demos aqui.