Pointez MeetingBaaS vers un stockage objet qui vous appartient et chaque enregistrement, transcription, chunk audio et log y atterrit à la place. Deux jeux d'identifiants, une vraie vérification d'accès, et un compte rendu honnête de ce que vous y perdez.
"Où vit l'enregistrement ?" est la question qui bloque les deals entreprise. Pour une banque, un hôpital, ou n'importe qui soumis à une exigence de résidence des données, "dans nos buckets, chiffré" n'est pas une réponse qu'ils peuvent remonter à leur équipe conformité.
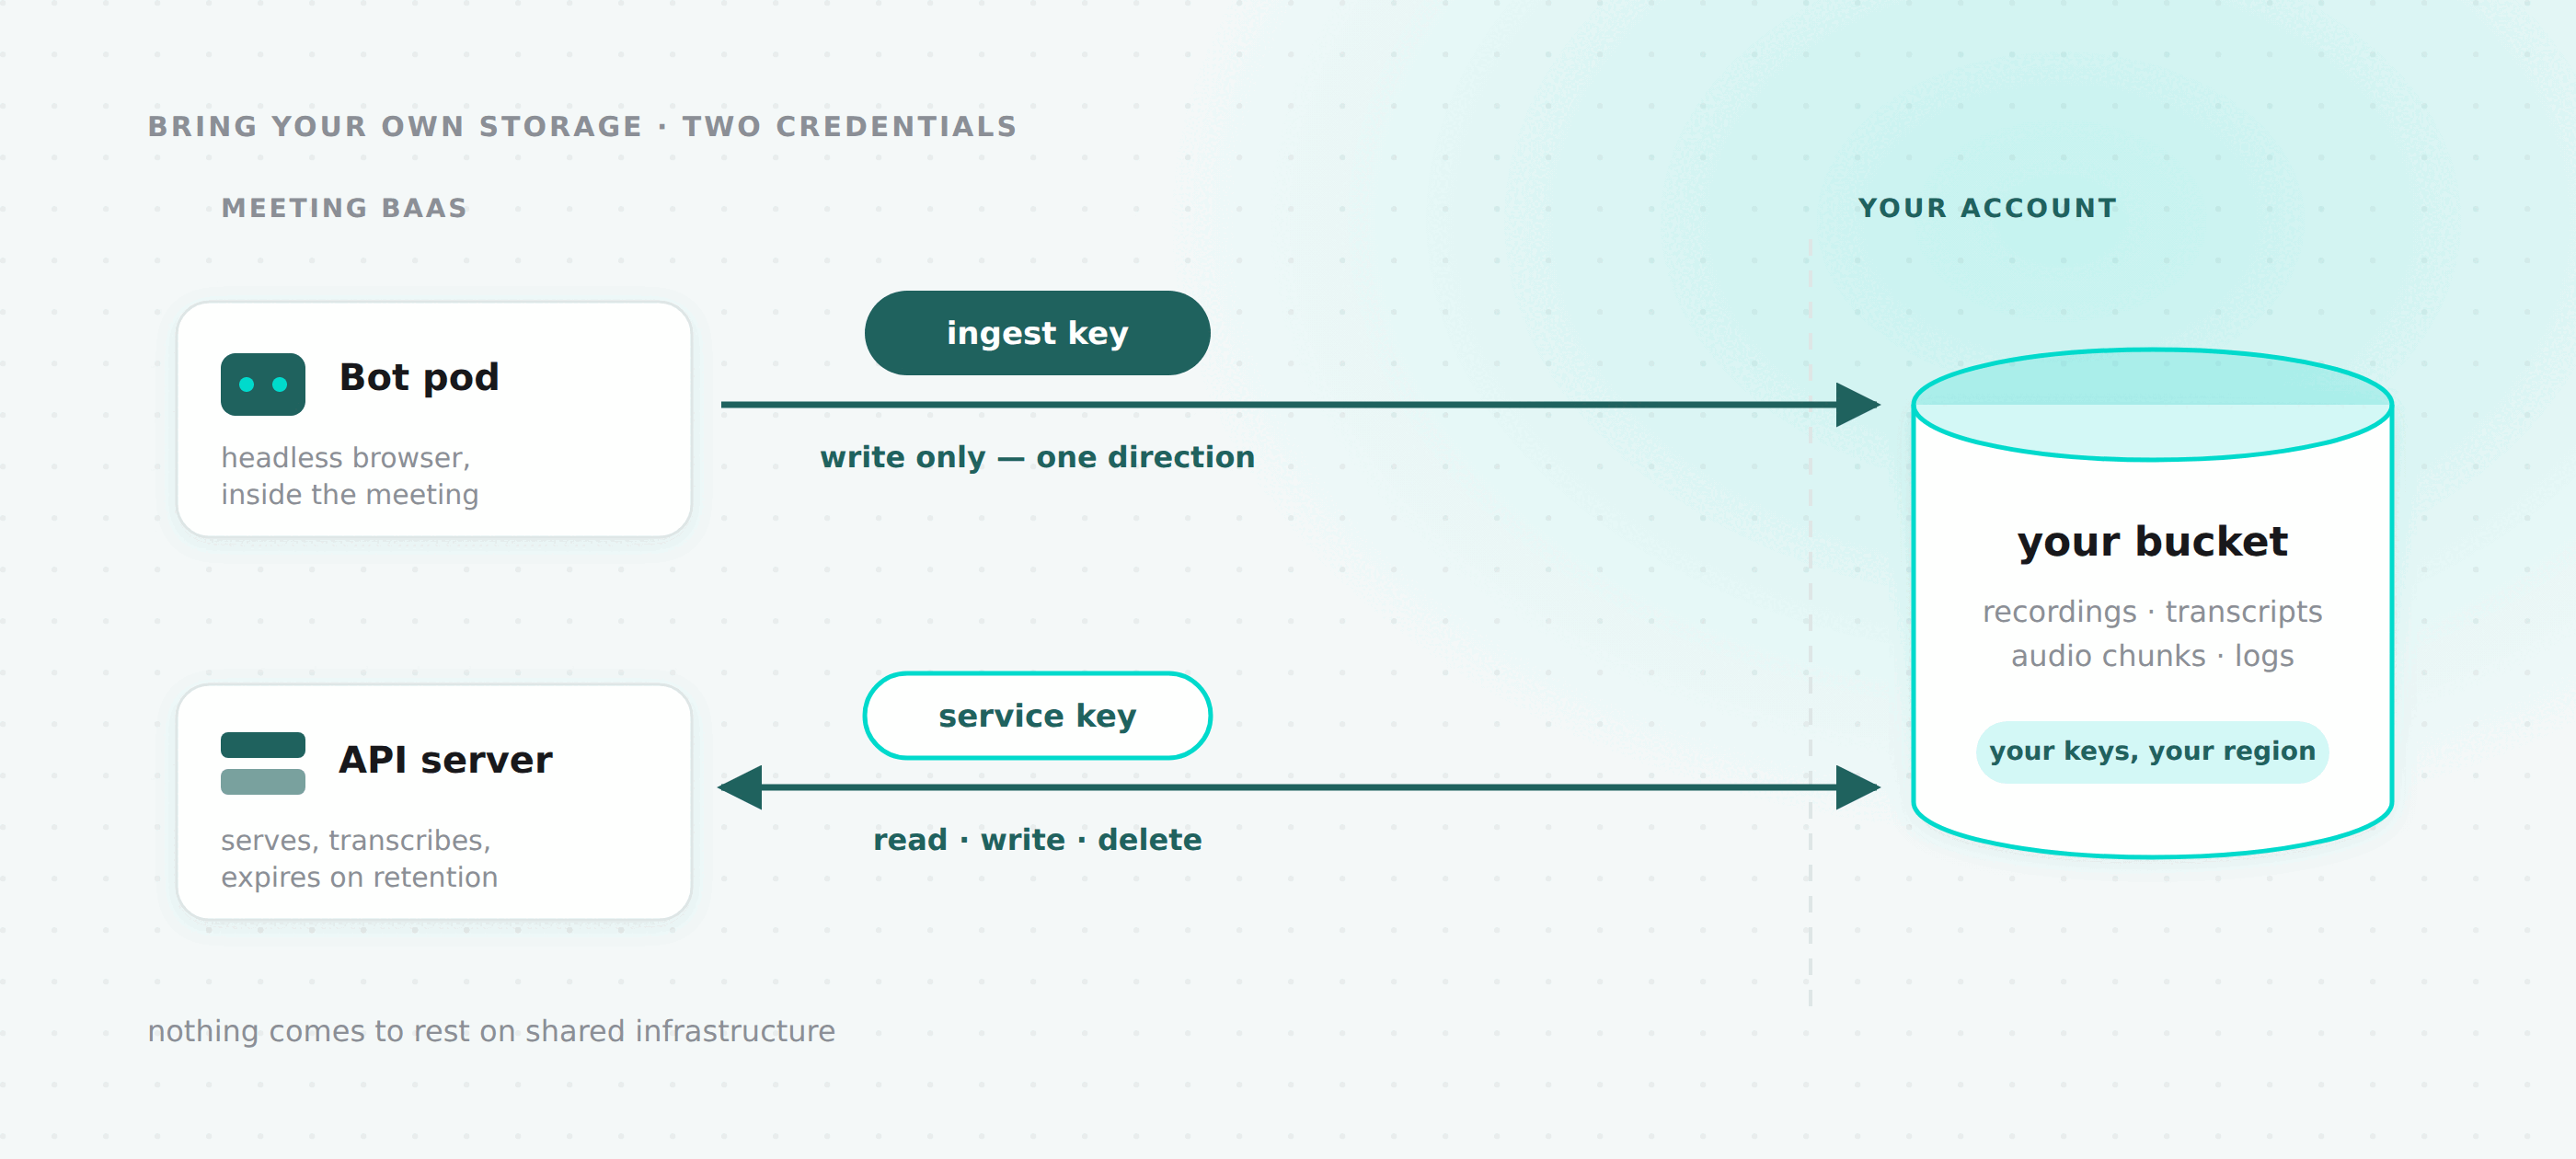
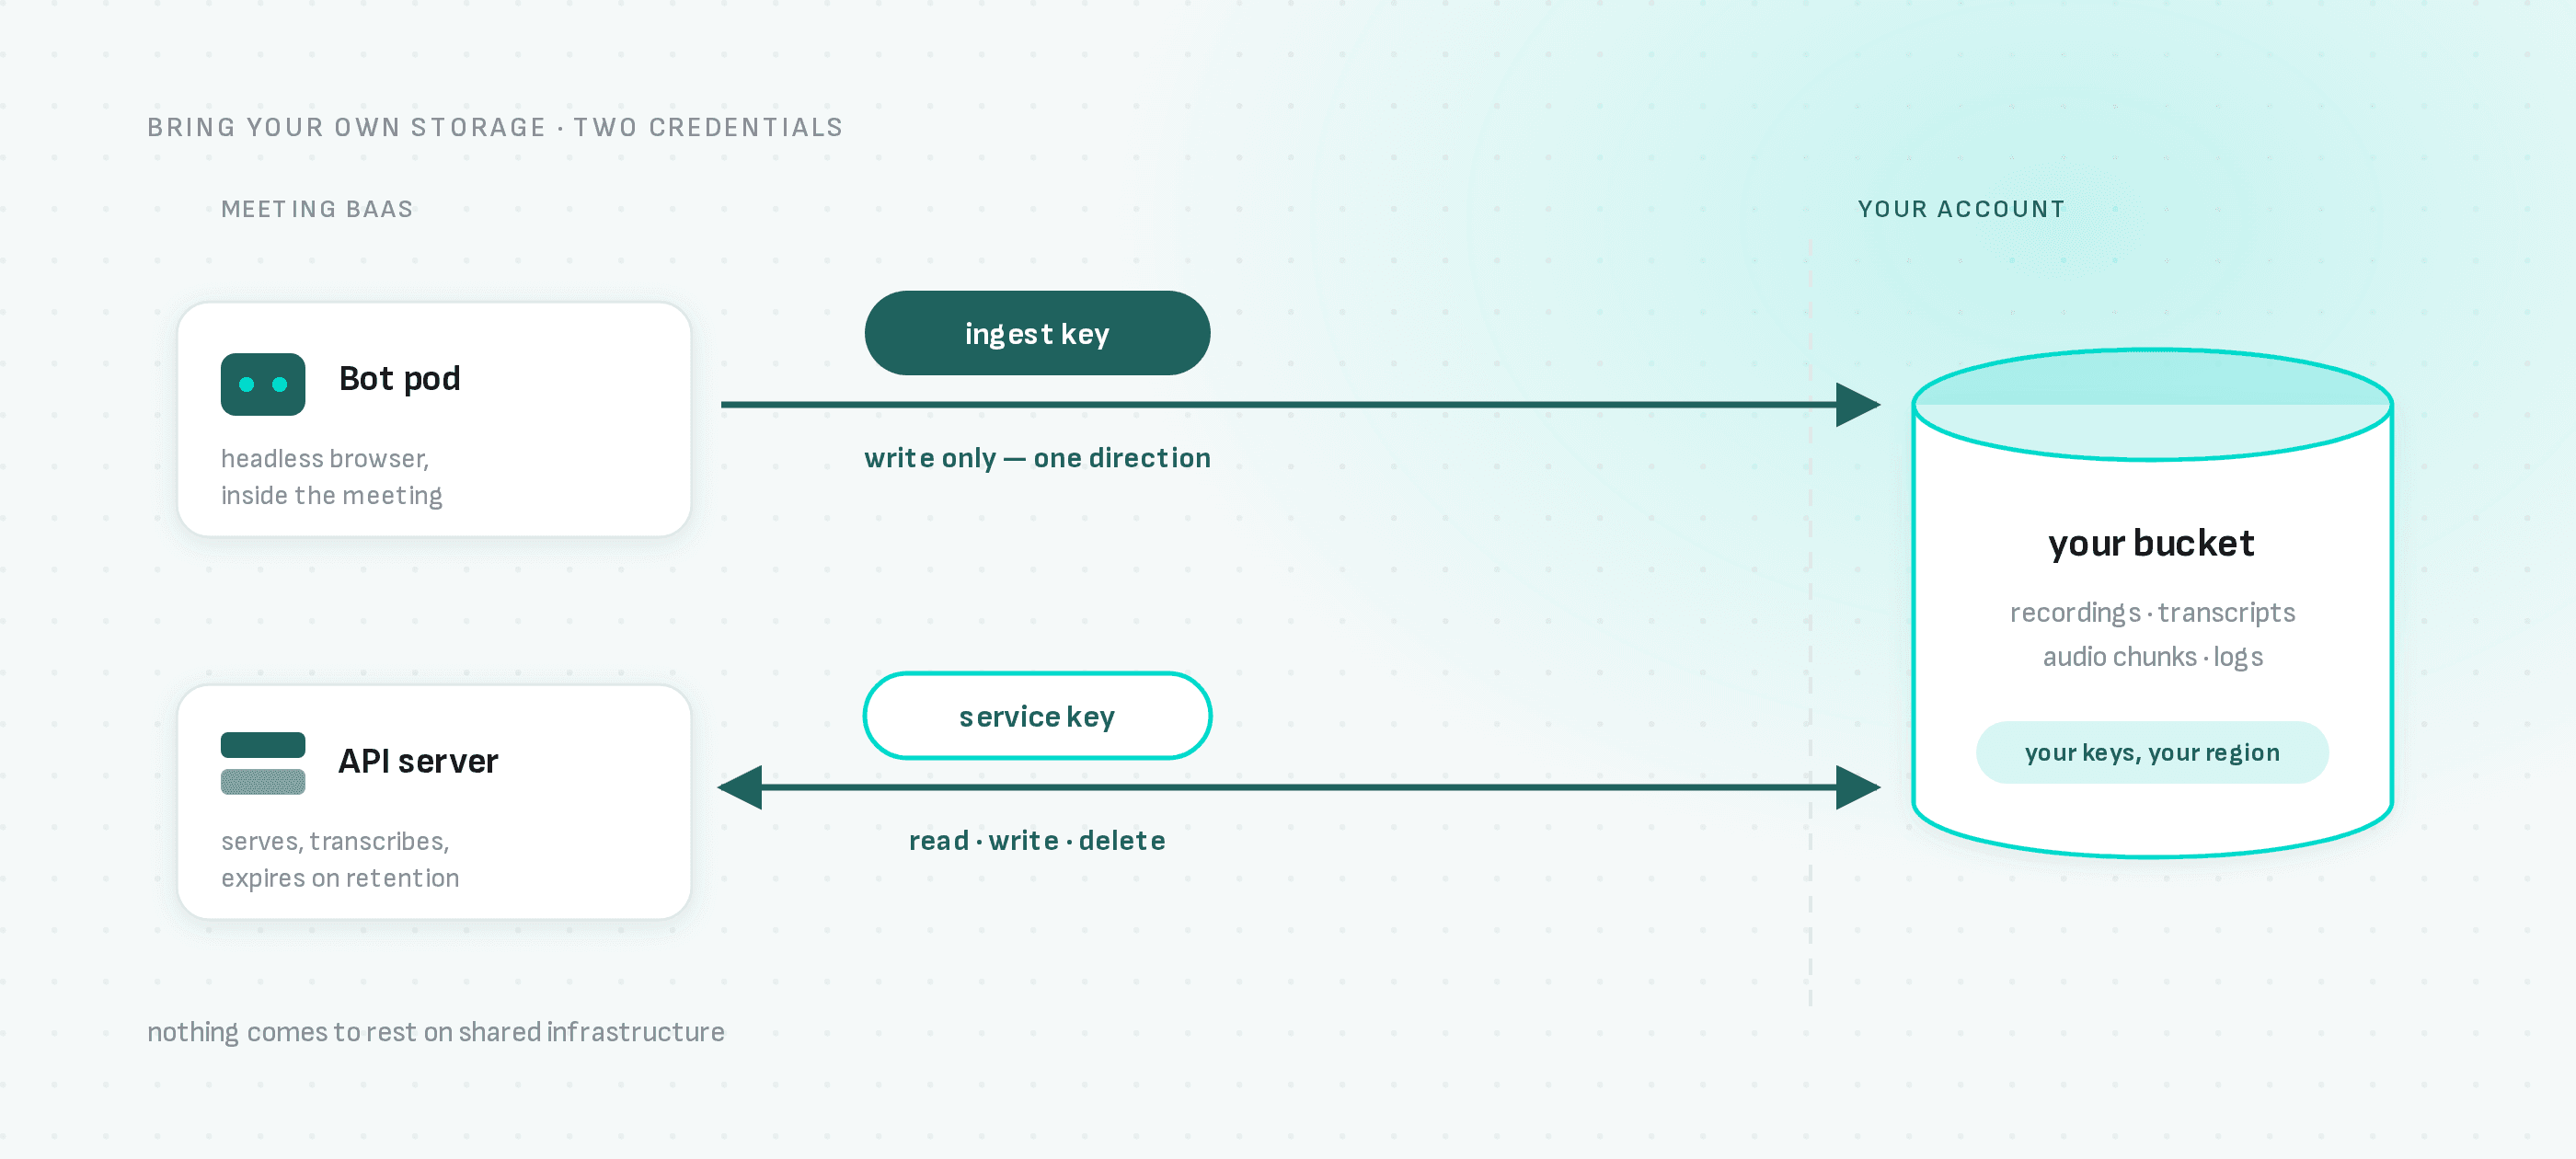
Alors maintenant, vous pouvez nous donner un bucket. Chaque artefact produit par vos bots à partir de ce moment-là, enregistrements, chunks audio, transcriptions, captures d'écran et logs, est écrit dans un stockage qui vous appartient, avec des identifiants que vous avez émis et que vous pouvez révoquer.
Bring Your Own Storage est disponible sur tous les plans, y compris le Pay as You Go. Il n'existe aucune barrière de mise à niveau liée à la fonctionnalité de stockage.
GET    /v2/storage-config          your current configuration, 404 if unset
PUT    /v2/storage-config          set or replace it
POST   /v2/storage-config/test     re-run the access check
DELETE /v2/storage-config          back to MeetingBaaS storage
Ou Settings → Storage dans le dashboard, qui correspond aux quatre mêmes handlers derrière l'authentification de session.
Deux credentials, séparés selon leur destination physique
C'est la décision de conception que je défendrais avec le plus de conviction, je vais donc commencer par là.
Vous fournissez deux paires de clés d'accès, et non une seule :
| Permissions | Où elle réside | |
|---|---|---|
| ingest | PutObject, PutObjectTagging, AbortMultipartUpload | Transmise au bot d'enregistrement. Quitte notre réseau. |
| service | GetObject, ListBucket, PutObject, DeleteObject | Serveur API uniquement. Ne quitte jamais notre réseau. |
La clé ingest est la seule credential qui s'approche de votre meeting. Elle est transmise à un pod exécutant un navigateur headless à l'intérieur d'un appel, ce qui est l'endroit le plus exposé où une credential de ce système peut se trouver. Elle peut écrire des objets. Elle ne peut pas en lire un, ne peut pas lister ce qui s'y trouve, et ne peut rien supprimer. Un pod compromis peut ajouter des données indésirables à un préfixe, et c'est là toute l'étendue du problème.
La clé service fait tout le reste : servir vos enregistrements via des URLs signées, écrire les transcriptions à leur arrivée, et supprimer les artefacts à l'expiration de votre fenêtre de rétention.
Il convient d'être précis sur un point. La clé service n'est pas en lecture seule, et la décrire ainsi serait un mensonge que vous finiriez par nous reprocher. Elle écrit et elle supprime, car l'API fait véritablement les deux. Ce que la séparation apporte, c'est que la credential dans l'emplacement risqué est la plus faible. C'est une réduction réelle du rayon d'impact, et ce n'est pas la même chose que le moindre privilège partout — je préfère vous dire exactement ce que vous obtenez.
Mise en place
{
  "endpoint": "https://s3.eu-west-3.amazonaws.com",
  "region": "eu-west-3",
  "force_path_style": false,
  "artifacts_bucket": "acme-meeting-artifacts",
  "audio_chunks_bucket": "acme-meeting-audio-chunks",
  "logs_bucket": "acme-meeting-logs",
  "allow_transient_spill": false,
  "ingest_access_key_id": "AKIAIOSFODNN7EXAMPLE",
  "ingest_secret_access_key": "...",
  "service_access_key_id": "AKIAI44QH8DHBEXAMPLE",
  "service_secret_access_key": "..."
}
Les trois noms de buckets peuvent tous désigner le même bucket. Les clés d'objets sont préfixées par l'id du bot dans tous les cas, donc rien n'entre en collision. force_path_style est ce dont MinIO, Ceph et la plupart des gateways auto-hébergés ont besoin ; AWS et Scaleway fonctionnent sans.
L'endpoint doit être en HTTPS public, sans credentials ni query string. Les buckets doivent être privés, car les artefacts sont servis via des URLs signées de courte durée, mais ils doivent être accessibles depuis internet : les fournisseurs de transcription récupèrent l'audio directement depuis une URL signée plutôt que de passer par notre proxy.
Autorisez l'origine du dashboard sur le bucket des artefacts pendant que vous y êtes. Le dashboard récupère les artefacts et lit le JSON des transcriptions plutôt que d'y pointer directement, ce qui constitue des lectures cross-origin contre votre endpoint — sans règle CORS, le navigateur rejette la response avant que quoi que ce soit puisse s'afficher. GET et HEAD depuis l'origine de votre dashboard constituent l'intégralité de la règle. À noter que PutBucketCors se situe un niveau au-dessus des permissions d'objets que détient la clé service, elle nécessite donc une credential de niveau propriétaire — la clé service retournant Forbidden indique que le périmètre fonctionne correctement, ce n'est pas un bug.
La lecture de la configuration vous renvoie les deux access key IDs, ce qui vous permet de savoir quelles credentials sont utilisées, mais jamais aucun secret. Jamais. Remplacer une configuration implique de ressaisir les deux secrets, car nous ne pouvons pas vous montrer ce qui s'y trouve.
La vérification d'accès, et pourquoi ce n'est pas une formalité
PUT vérifie la configuration avant de la stocker. Pas en appelant simplement ListBuckets et en s'en contentant.
La clé ingest écrit un objet marqueur dans chaque bucket distinct. Ensuite, la clé service lit cet objet, l'écrit, et le supprime.
Chaque opération est exercée par la credential qui l'effectuera réellement en production, de sorte que la vérification échoue de la même manière que la production le ferait. Les quatre sont indispensables : l'upload ingest correspond à l'arrivée des enregistrements, l'upload service correspond à l'écriture des transcriptions, la lecture correspond à la façon dont les artefacts sont servis, et la suppression correspond à l'expiration effective de la rétention.
La partie véritablement utile consiste à séparer l'écriture de la lecture. Le marqueur est écrit par une credential et doit être trouvé par l'autre. Cela détecte l'échec que personne ne teste : deux paires de clés parfaitement valides chacune, mais pointant vers des buckets différents ou des comptes différents. Tous les health checks à credential unique au monde valident cette configuration, et vous perdez ensuite un enregistrement.
Sans cela, le premier signe d'un nom de bucket mal saisi est un échec d'upload à la fin d'un vrai meeting, après que le disque local du pod ait disparu. Lorsque la vérification échoue, nous affichons le message du fournisseur tel quel plutôt qu'une erreur générique, car « la clé ingest ne peut pas écrire dans le bucket des artefacts » représente toute la valeur de son exécution.
Vous pouvez la relancer à tout moment avec POST /v2/storage-config/test, ce qui est souhaitable après une rotation de clés ou la modification d'une politique de bucket.
Une chose qu'elle ne peut délibérément pas détecter : le CORS. La vérification s'exécute depuis nos serveurs, où le CORS ne s'applique pas, donc un bucket peut réussir toutes les opérations ci-dessus et refuser quand même de transmettre un enregistrement à un navigateur. Cette lacune nous appartient à combler, et en attendant, la note concernant l'autorisation de l'origine du dashboard est ce qui fait la différence entre une vérification réussie et un dashboard qui n'affiche rien.
L'invariant dont tout le reste découle
Un bot résout toujours vers le stockage sur lequel il a été écrit, jamais vers ce avec quoi son équipe est configurée aujourd'hui.
Lorsqu'un bot est déployé, la configuration de stockage en vigueur à ce moment est horodatée sur l'enregistrement du bot. Chaque lecture, chaque URL signée et chaque suppression pour ce bot sont résolues via cet horodatage. Pas via l'équipe.
Cela ressemble à un détail d'implémentation. C'est la raison pour laquelle la fonctionnalité peut être activée en toute sécurité, et quatre conséquences en découlent directement :
Modifier votre configuration insère une nouvelle ligne et désactive l'ancienne. Elle ne se met jamais à jour en place. La mutation de la ligne redirigerait silencieusement les artefacts de tous les bots existants vers un bucket où ils n'existent pas.
DELETE /v2/storage-config ne fait que basculer un flag. Rien n'est supprimé, ni d'un côté ni de l'autre. Une suppression définitive retirerait les credentials dont les anciens bots ont encore besoin et orpheliserait chaque enregistrement de votre compte.
La résolution ignore délibérément si une configuration est activée. La désactivation empêche de nouveaux artefacts d'aller dans votre bucket. Elle ne doit pas orpheliser ceux qui s'y trouvent déjà.
Une configuration horodatée introuvable génère une erreur plutôt que de revenir à nos buckets. Un repli silencieux signalerait vos artefacts comme manquants, et lors d'une suppression liée à la rétention, il laisserait silencieusement vos données en place tout en rapportant un succès. L'échec explicite est le comportement correct.
La version pratique : configurez-le, modifiez-le ou supprimez-le quand vous le souhaitez. Les anciens enregistrements continuent de fonctionner à travers tout cela. La seule chose qui rend les anciens artefacts illisibles est la révocation de notre accès de votre côté, ce qui est votre décision à prendre et fonctionne exactement comme vous vous y attendez.
L'échange que vous faites réellement
allow_transient_spill est défini sur false par défaut pour les équipes utilisant leur propre stockage, ce qui est l'opposé de notre valeur par défaut de plateforme. Voici ce que cela signifie, en détail, car c'est le seul endroit où cette fonctionnalité vous coûte quelque chose.
Normalement, lorsqu'un upload échoue, nous copions l'artefact sur notre propre volume réseau et une tâche de réconciliation le pousse ultérieurement. Ce chemin copie l'intégralité du meeting : la vidéo, l'audio, la sortie de séparation des interlocuteurs, chaque fragment. Sur notre infrastructure, dans notre compte.
Ce qui est exactement ce à quoi un client avec exigences de résidence de données a voulu éviter. Pire encore, ces clients empruntent ce chemin plus souvent que les clients de la plateforme, car leur bucket est hors de notre réseau et souvent chez un fournisseur différent.
Donc avec allow_transient_spill: false, le repli est désactivé sur tous les types de bots et le consumer. Un upload qui épuise ses tentatives est signalé comme ayant échoué, et l'artefact est perdu.
C'est l'échange : durabilité contre résidence des données. Nous l'atténuons partiellement en donnant au client d'upload du bot six tentatives au lieu des trois par défaut du SDK, donc un incident momentané ne vous coûte pas un enregistrement, mais une panne prolongée de votre bucket le fera quand même.
Définissez-le sur true si vous préférez conserver l'enregistrement plutôt que maintenir la garantie. Le dashboard affiche un avertissement expliquant précisément ce à quoi vous renoncez lorsque vous le basculez, car ce ne doit pas être une case que vous cochez sans y prêter attention.
Si des enregistrements disparaissent et que votre bucket a subi une panne, c'est la première chose à vérifier.
Ce que cela ne fait pas
Quatre points, énoncés dès le départ pour que personne ne les découvre plus tard.
Rien de ce qui a déjà été enregistré n'est déplacé. Il n'y a pas de migration. Chaque bot continue de résoudre vers l'endroit où il a été écrit, ce qui rend l'activation de cette fonctionnalité sûre, mais signifie également que votre historique reste sur nos buckets.
Pas de configuration de préfixe par bucket. Les clés sont <bot_uuid>/… et c'est fixe.
Cela ne rend pas la résidence des données hermétique à elle seule. Les pods de bots conservent toujours l'enregistrement sur le disque local pendant la durée du meeting. Ce que cela ferme, c'est le seul chemin par lequel votre enregistrement vient à reposer sur l'infrastructure partagée de MeetingBaaS.
Les assets du dashboard restent sur nos buckets. Les logos, les avatars d'utilisateurs et les pièces jointes de support ne sont pas des données de meeting et ne sont pas couverts.
Retour en arrière
DELETE /v2/storage-config, sûr à tout moment. Les nouveaux bots reviennent immédiatement sur notre stockage. Les bots existants continuent de résoudre vers vos buckets et continuent de fonctionner.
- Six Fournisseurs de Transcription, Une Seule API — associez une région de bucket à une région de fournisseur pour une résidence de bout en bout
- Héberger Meeting BaaS chez vous — si posséder le bucket ne va pas assez loin
- Référence de l'API Meeting BaaS
Si vous travaillez dans le cadre d’une exigence de résidence et souhaitez savoir exactement quels composants touchent à quoi, contactez-nous. Nous vous donnerons la même réponse que celle que nous avons donnée ici.