L'architecture derrière chaque assistant IA de meeting : un bot enregistre l'appel, des webhooks transmettent la transcription, un LLM rédige le résumé. Voici le pipeline complet avec le code.

Chaque assistant IA de meeting — les outils de prise de notes, les analyseurs d'appels commerciaux, les enregistreurs de conformité — repose sur le même pipeline en trois étapes :
- Capture : un bot rejoint le meeting et l'enregistre
- Transcription : la parole devient du texte attribué à chaque interlocuteur
- Analyse : un LLM transforme la transcription en résumés, en points d'action ou en mises à jour CRM
Les étapes 1 et 2 sont de l'infrastructure. L'étape 3 est votre produit. Ce guide vous montre comment ramener les étapes 1 et 2 à un seul appel API afin de consacrer votre temps à l'étape 3.
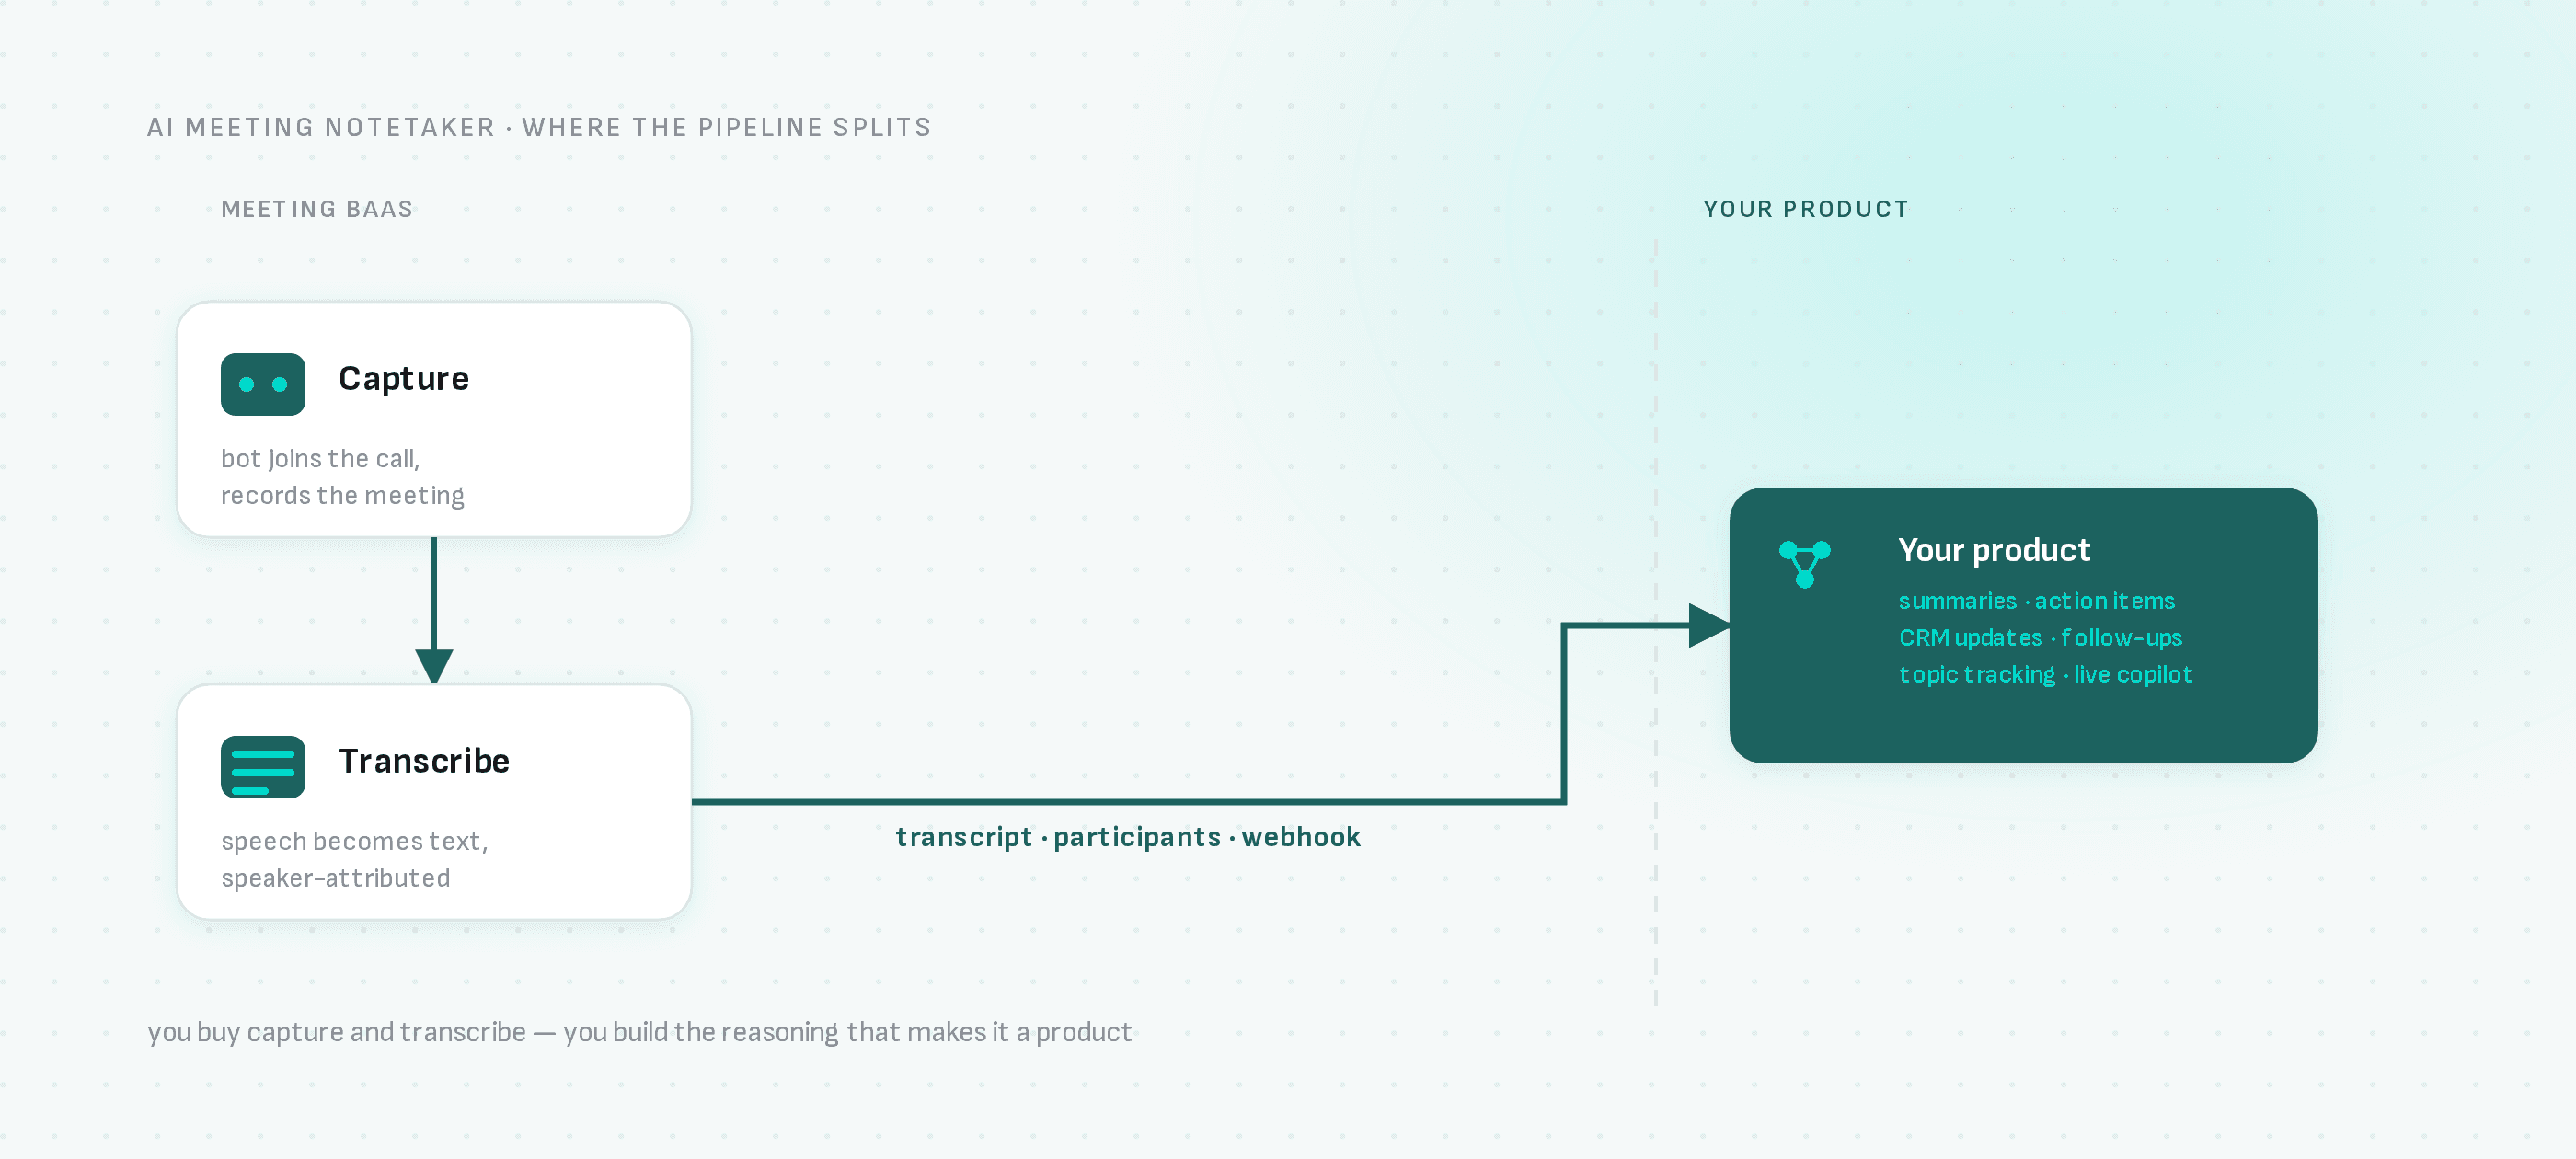
La couche de capture est la partie difficile — des bots qui survivent aux salles d'attente, aux changements de disposition et aux appels de quatre heures sur Zoom, Google Meet et Microsoft Teams. C'est la partie que vous devriez acheter, et non construire.
La couche de capture : une seule requête POST
import { createBaasClient } from "@meeting-baas/sdk";

const client = createBaasClient({
  api_key: process.env.MEETING_BAAS_API_KEY,
  api_version: "v2"
});

const { success, data, error } = await client.createBot({
  bot_name: "Acme Notetaker",
  meeting_url: meetingUrl // Zoom, Google Meet or Microsoft Teams
});
La même requête fonctionne pour les trois plateformes. Avec l'intégration calendrier activée, vous pouvez même ignorer cette étape — les bots sont planifiés automatiquement pour les prochains meetings de vos utilisateurs.
La transcription arrive par webhook
Lorsque le meeting se termine, votre webhook reçoit la transcription avec l'attribution des interlocuteurs, la liste des participants et l'URL de l'enregistrement. Un handler minimal :
export async function POST(req: Request) {
  const rawBody = await req.text();

  // Verify the webhook signature over the raw body before parsing —
  // see the webhooks documentation for the signing scheme
  if (!verifySignature(req.headers, rawBody)) {
    return new Response("invalid signature", { status: 401 });
  }

  const event = JSON.parse(rawBody);

  if (event.event === "complete") {
    const { bot_id, transcript, participants } = event.data;
    // Deduplicate on bot_id so replayed deliveries don't re-run the LLM
    if (await alreadyProcessed(bot_id)) return new Response("ok");
    await summarize(bot_id, transcript, participants);
  }

  return new Response("ok");
}
La séparation des interlocuteurs est incluse avec chaque enregistrement, et les segments sont alignés sur les noms réels des participants — votre prompt LLM reçoit « Sarah : nous livrerons vendredi » au lieu de « Locuteur 2 : nous livrerons vendredi ». C'est cette différence qui rend l'extraction des points d'action réellement efficace.
La couche de raisonnement : votre produit
Avec une transcription claire attribuée aux interlocuteurs, l'étape LLM est un prompt, pas un projet :
async function summarize(botId: string, transcript: Segment[], participants: Participant[]) {
  const text = transcript
    .map((segment) => `${segment.speaker}: ${segment.text}`)
    .join("\n");

  const summary = await llm.complete({
    prompt: `Summarize this meeting. Extract decisions and action items with owners.\n\n${text}`
  });

  await saveNotes(botId, summary);
}
À partir de là, la différenciation est un travail produit : des e-mails de suivi par participant, l'enrichissement CRM, le suivi des sujets à travers des meetings récurrents, ou un bot vocal qui répond aux questions en direct — l'API speaking bots couvre ce dernier cas.
Le coût d'utilisation
L'enregistrement coûte 1 token par heure avec la séparation des interlocuteurs incluse ; la transcription ajoute 0,25 token par heure. Avec des token packs à 0,35–0,50 $ par token, une heure de meeting entièrement transcrite coûte 0,44–0,63 $ — avant vos coûts LLM, qui pour la transcription d'un meeting d'une heure représentent généralement un ou deux centimes.
Prochaines étapes
- Présentation de l'API meeting bot — la couche de capture en détail
- API de transcription de meeting — langues, séparation des interlocuteurs, BYOK
- Guides par plateforme : Zoom · Google Meet · Microsoft Teams
- Documentation API