Apunte MeetingBaaS a un almacenamiento de objetos que usted posee y cada grabación, transcripción, fragmento de audio y log irá allí. Dos credenciales, una comprobación de acceso de verdad y un relato honesto de lo que se pierde a cambio.
"¿Dónde vive la grabación?" es la pregunta que frena los acuerdos empresariales. Para un banco, un hospital o cualquiera que opere bajo un requisito de residencia de datos, "en nuestros buckets, cifrada" no es una respuesta que puedan llevarle a su equipo de compliance.
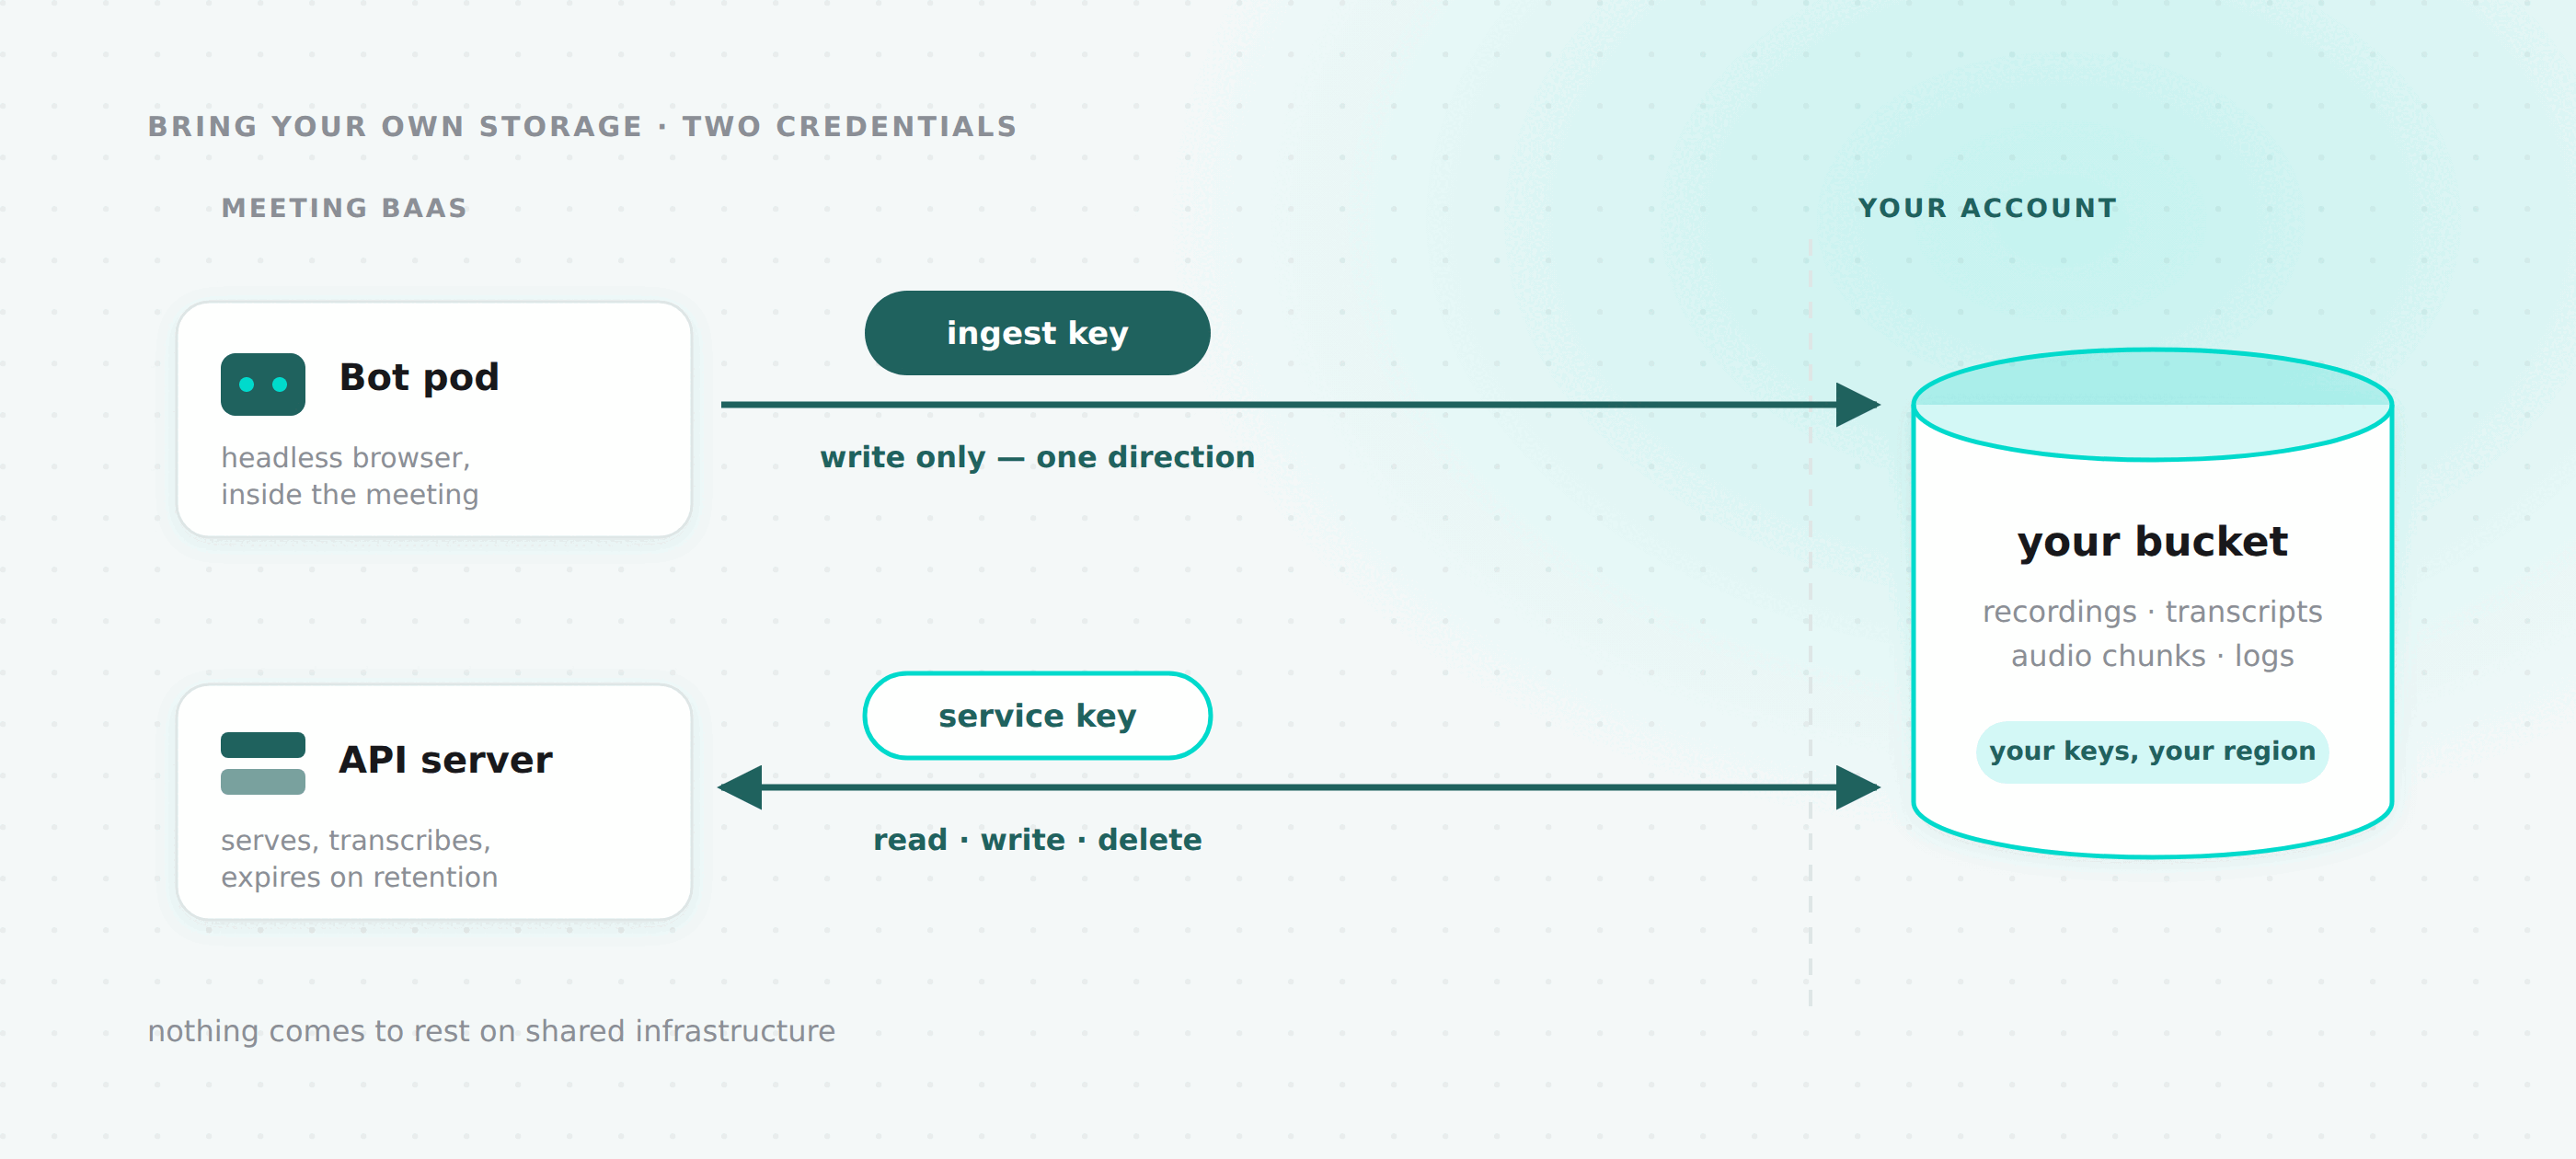
Así que ahora puede darnos un bucket. Cada artefacto que produzcan sus bots a partir de ese momento, grabaciones, fragmentos de audio, transcripciones, capturas de pantalla y logs, se escribe en un almacenamiento que usted posee, con credenciales que usted emitió y puede revocar.
Bring Your Own Storage está disponible en todos los planes, incluido Pay as You Go. No hay ninguna restricción de acceso por funcionalidad de almacenamiento.
GET    /v2/storage-config          your current configuration, 404 if unset
PUT    /v2/storage-config          set or replace it
POST   /v2/storage-config/test     re-run the access check
DELETE /v2/storage-config          back to MeetingBaaS storage
O en Configuración → Almacenamiento en el dashboard, que utiliza los mismos cuatro handlers detrás de la autenticación de sesión.
Dos credenciales, separadas según su destino físico
Esta es la decisión de diseño que más defendería, así que comenzaré por aquí.
Usted proporciona dos pares de claves de acceso, no uno:
| Permisos | Dónde reside | |
|---|---|---|
| ingest | PutObject, PutObjectTagging, AbortMultipartUpload | Se entrega al bot de grabación. Sale de nuestra red. |
| service | GetObject, ListBucket, PutObject, DeleteObject | Solo en nuestro servidor API. Nunca sale. |
La clave de ingest es la única credencial que se acerca a su reunión. Se traslada a un pod que ejecuta un navegador headless dentro de una llamada, que es el lugar más expuesto donde puede encontrarse cualquier credencial en este sistema. Puede escribir objetos, pero no puede leerlos, listar lo que existe ni eliminar nada. Un pod comprometido puede agregar datos basura a un prefijo, y eso es todo el alcance del daño.
La clave de service hace todo lo demás: servir sus grabaciones a través de URLs firmadas, escribir las transcripciones cuando llegan y eliminar los artefactos cuando vence su ventana de retención.
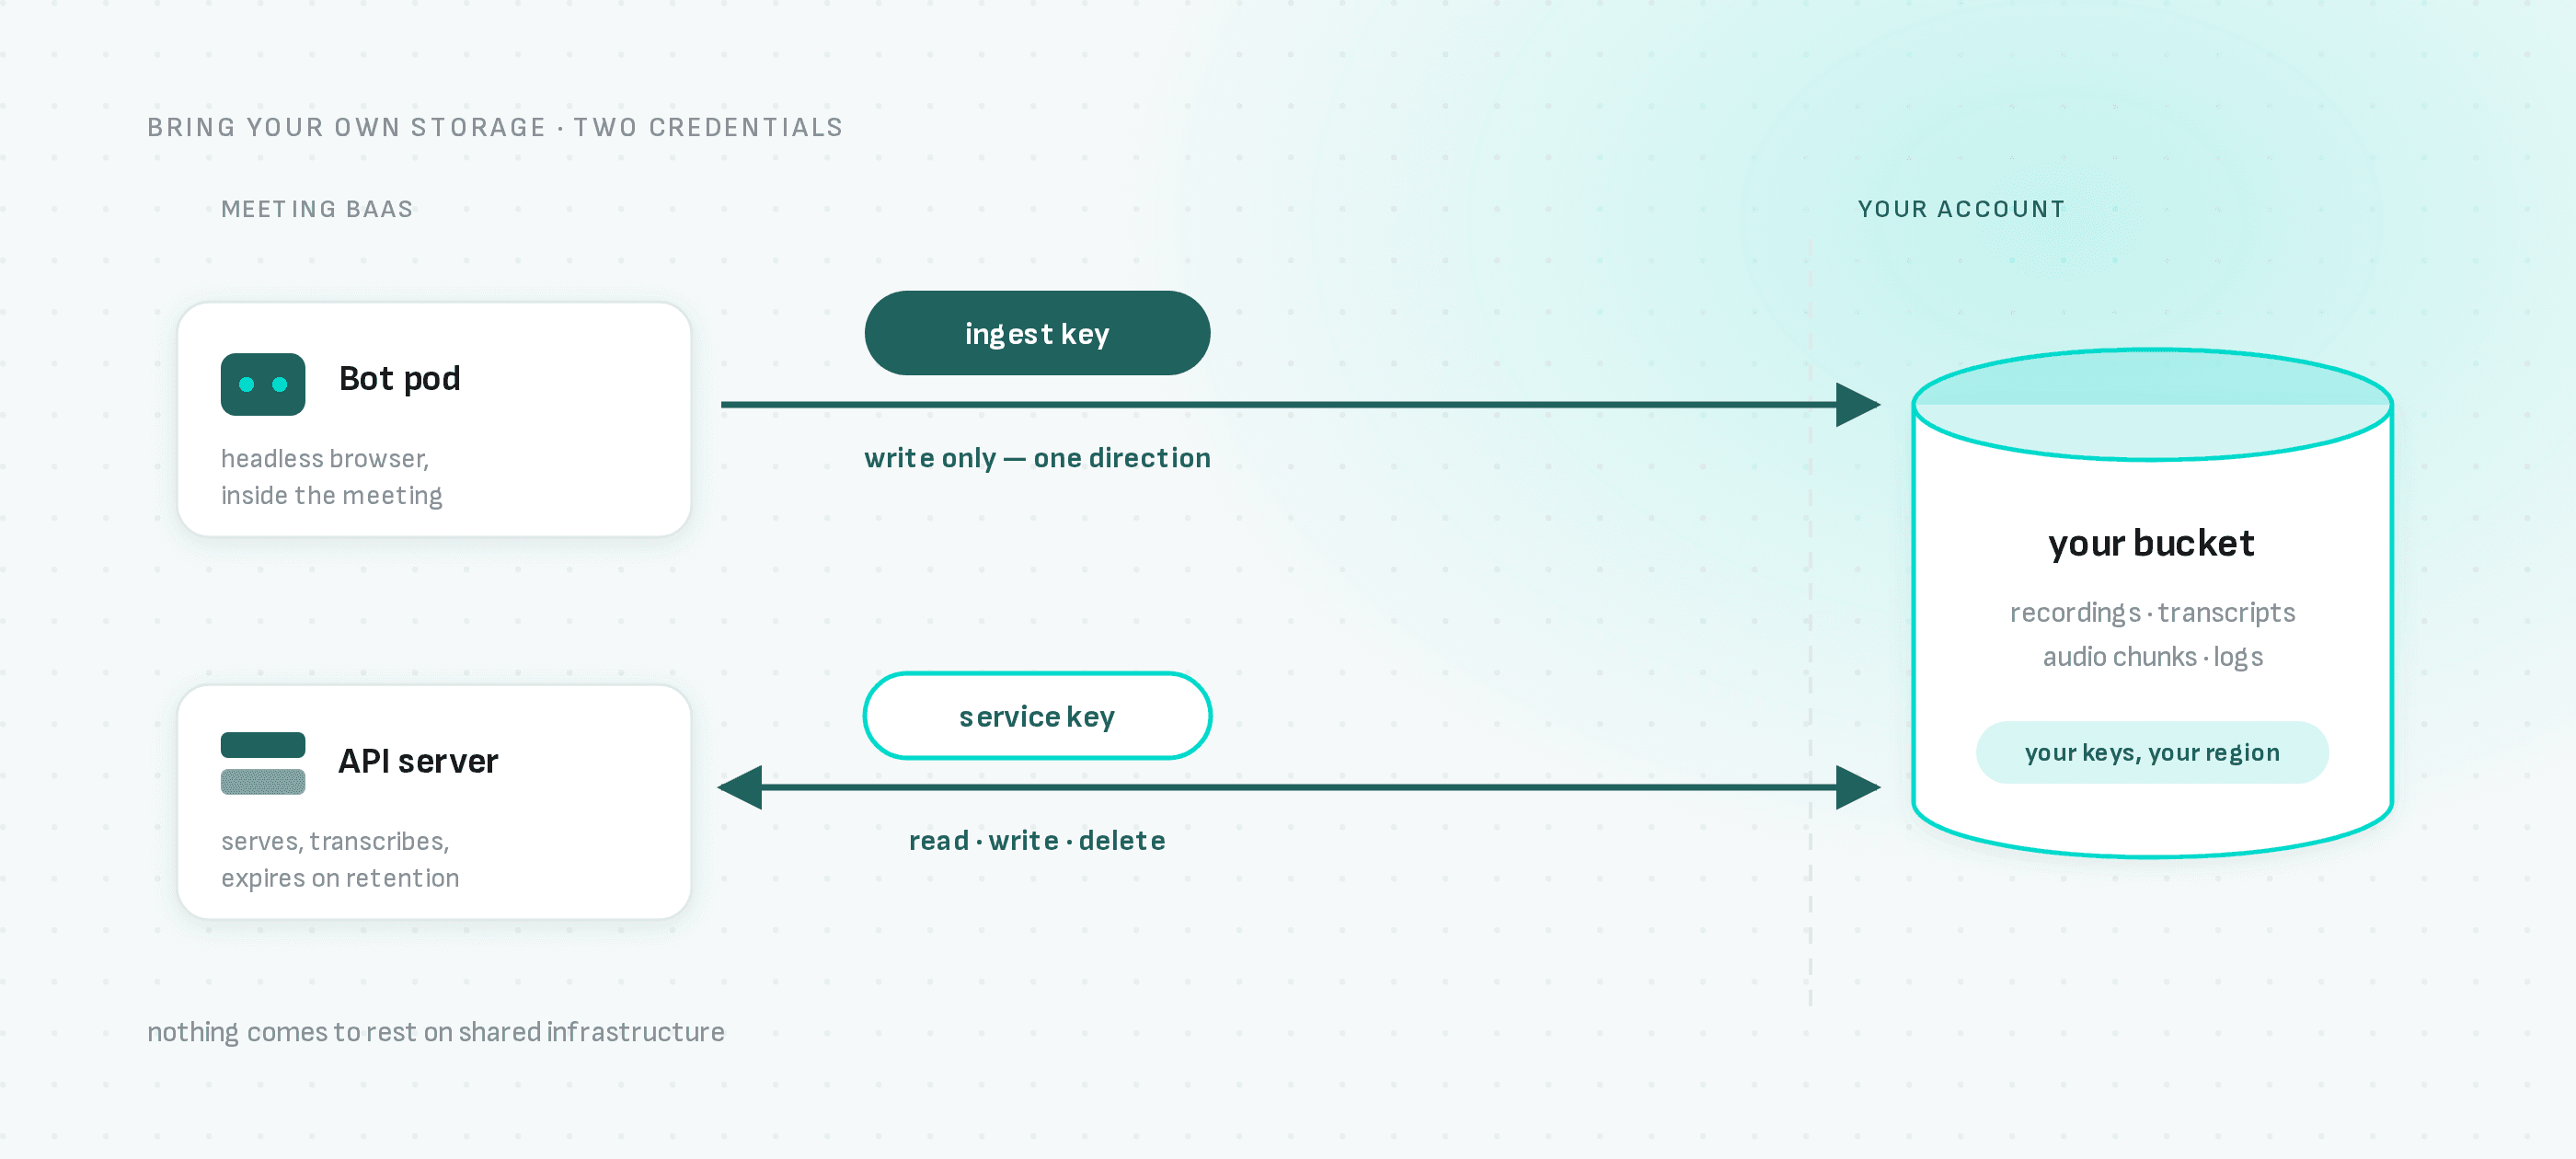
Vale la pena ser precisos sobre algo aquí. La clave de service no es de solo lectura, y describirla así sería una mentira que eventualmente nos descubrirían. Escribe y elimina, porque la API realmente hace ambas cosas. Lo que aporta la separación es que la credencial en la ubicación de mayor riesgo es la más débil. Eso es una reducción real del radio de impacto, y no es lo mismo que el principio de mínimo privilegio en todas partes. Prefiero decirles exactamente cuál de los dos están obteniendo.
Configuración
{
  "endpoint": "https://s3.eu-west-3.amazonaws.com",
  "region": "eu-west-3",
  "force_path_style": false,
  "artifacts_bucket": "acme-meeting-artifacts",
  "audio_chunks_bucket": "acme-meeting-audio-chunks",
  "logs_bucket": "acme-meeting-logs",
  "allow_transient_spill": false,
  "ingest_access_key_id": "AKIAIOSFODNN7EXAMPLE",
  "ingest_secret_access_key": "...",
  "service_access_key_id": "AKIAI44QH8DHBEXAMPLE",
  "service_secret_access_key": "..."
}
Los tres nombres de bucket pueden ser el mismo bucket. Las claves de objeto llevan el prefijo del id del bot de todas formas, por lo que no hay colisiones. force_path_style es lo que necesitan MinIO, Ceph y la mayoría de los gateways self-hosted; AWS y Scaleway funcionan sin él.
El endpoint debe ser HTTPS público sin credenciales ni query string. Los buckets deben ser privados, ya que los artefactos se sirven a través de URLs firmadas de corta duración, pero deben ser accesibles desde internet: los proveedores de transcripción obtienen el audio directamente desde una URL firmada en lugar de hacer proxy a través de nosotros.
Permita el origen del dashboard en el bucket de artefactos mientras está en él. El dashboard obtiene artefactos y lee el JSON de transcripción en lugar de enlazar directamente a ellos, por lo que son lecturas de origen cruzado contra su endpoint, y sin una regla CORS el navegador descarta la respuesta antes de que algo pueda renderizarse. GET e HEAD desde el origen de su dashboard es toda la regla. Vale la pena saber que PutBucketCors está un nivel por encima de los permisos de objeto que tiene la clave de service, por lo que necesita una credencial de nivel propietario — la clave de service devolviendo Forbidden allí es el alcance funcionando correctamente, no un bug.
Al leer la configuración se obtienen ambos IDs de clave de acceso, para que pueda saber qué credenciales están en uso, y ninguno de los secretos. Nunca. Reemplazar una configuración implica volver a ingresar ambos secretos, porque no podemos mostrarle lo que hay allí.
La verificación de acceso, y por qué no es una formalidad
PUT verifica la configuración antes de almacenarla. No llamando a ListBuckets y dando el asunto por concluido.
La clave de ingest escribe un objeto marcador en cada bucket distinto. Luego la clave de service lee ese objeto, lo escribe y lo elimina.
Cada verbo es ejecutado por la credencial que realmente lo realizará en producción, por lo que la verificación falla de la misma manera que lo haría en producción. Las cuatro acciones son esenciales: la carga de ingest es cómo llegan las grabaciones, la carga de service es cómo se escriben las transcripciones, la lectura es cómo se sirven los artefactos, y la eliminación es cómo la retención expira efectivamente cualquier elemento.
La parte realmente útil es separar escritura de lectura. El marcador es escrito por una credencial y debe ser encontrado por la otra. Eso detecta el fallo que nadie prueba: dos pares de claves perfectamente válidos, pero apuntando a buckets diferentes o a cuentas diferentes. Cualquier verificación de salud con una sola credencial superaría esa configuración, y entonces se pierde una grabación.
Sin esto, la primera señal de un nombre de bucket mal escrito es una carga fallida al final de una reunión real, después de que el disco local del pod ya no existe. Cuando la verificación falla, mostramos el mensaje del proveedor tal como es en lugar de un error genérico, porque "la clave de ingest no puede escribir en el bucket de artefactos" es el valor completo de ejecutarla.
Puede volver a ejecutarla en cualquier momento con POST /v2/storage-config/test, que es lo que se desea hacer después de rotar claves o cambiar una política de bucket.
Una cosa que deliberadamente no puede detectar: CORS. La verificación se ejecuta desde nuestros servidores, donde CORS no aplica, por lo que un bucket puede superar todos los verbos anteriores y aun así negarse a entregar una grabación al navegador. Esa brecha nos corresponde cerrarla, y hasta que lo hagamos, la nota sobre permitir el origen del dashboard es lo que se interpone entre una verificación exitosa y un dashboard que no muestra nada.
El invariante del que todo lo demás se deriva
Un bot siempre resuelve al almacenamiento en el que fue escrito, nunca al que su equipo tenga configurado hoy.
Cuando se despacha un bot, la configuración de almacenamiento vigente en ese momento queda registrada en el registro del bot. Cada lectura, cada URL firmada y cada eliminación para ese bot se resuelve a través de ese registro. No a través del equipo.
Parece un detalle de implementación. Es la razón por la que la funcionalidad es segura de activar, y cuatro consecuencias se derivan directamente de ello:
Cambiar la configuración inserta una nueva fila y deshabilita la anterior. Nunca se actualiza en el lugar. Mutar la fila redirigiría silenciosamente los artefactos de todos los bots existentes a un bucket donde no existen.
DELETE /v2/storage-config solo cambia una bandera. No se elimina nada, en ninguno de los lados. Una eliminación definitiva quitaría las credenciales que los bots más antiguos aún necesitan y dejaría huérfanas todas las grabaciones de su cuenta.
La resolución deliberadamente ignora si una configuración está habilitada. Deshabilitar evita que nuevos artefactos vayan a su bucket. No debe dejar huérfanos los que ya están allí.
Una configuración registrada que no puede encontrarse genera un error en lugar de recurrir a nuestros buckets. Recurrir a ellos reportaría sus artefactos como faltantes, y en una eliminación por retención dejaría silenciosamente sus datos atrás mientras reporta éxito. El fallo explícito es el comportamiento correcto.
La versión práctica: configúrelo, cámbielo o elimínelo cuando quiera. Las grabaciones antiguas siguen funcionando a través de todo eso. Lo único que hace que los artefactos antiguos sean ilegibles es revocar nuestro acceso desde su lado, lo cual es su decisión y funciona exactamente como esperaría.
El intercambio que realmente está haciendo
allow_transient_spill tiene por defecto false para los equipos con su propio almacenamiento, que es lo contrario al valor predeterminado de nuestra plataforma. Esto es lo que significa, en su totalidad, porque es el único lugar donde esta funcionalidad tiene un costo.
Normalmente, cuando una carga falla, copiamos el artefacto en nuestro propio volumen de red y un trabajo de reconciliación lo envía más tarde. Ese proceso copia toda la reunión: el video, el audio, la salida de separación de interlocutores, cada fragmento. En nuestra infraestructura, en nuestra cuenta.
Lo cual es exactamente lo que un cliente de residencia se inscribió para evitar. Peor aún, los clientes de residencia llegan a ese camino más que los clientes de plataforma, porque su bucket está fuera de nuestra red y a menudo en un proveedor completamente diferente.
Entonces con allow_transient_spill: false, el fallback está desactivado en todos los tipos de bot y el consumidor. Una carga que agota sus reintentos se reporta como fallida, y el artefacto se pierde.
Ese es el intercambio: durabilidad por residencia. Lo compensamos parcialmente dando al cliente de carga del bot seis intentos en lugar de los tres predeterminados del SDK, para que una interrupción breve no le cueste una grabación, pero una interrupción sostenida en su bucket sí lo hará.
Configúrelo en true si prefiere conservar la grabación antes que mantener la garantía. El dashboard muestra una advertencia explicando exactamente qué está cediendo cuando lo activa, porque no debería ser una casilla que se marque sin pensar.
Si faltan grabaciones y su bucket tuvo una interrupción, eso es lo primero que debe verificar.
Lo que esto no hace
Cuatro cosas, declaradas de antemano para que nadie las descubra más tarde.
Nada de lo ya grabado se mueve. No hay migración. Cada bot sigue resolviendo al lugar donde fue escrito, lo cual es lo que hace seguro activar esto, y también significa que su historial permanece en nuestros buckets.
Sin configuración de prefijo por bucket. Las claves son <bot_uuid>/… y eso es fijo.
Esto no hace que la residencia sea hermética por sí solo. Los pods de bot aún retienen la grabación en disco local mientras la reunión está en curso. Lo que cierra es el único camino donde su grabación queda en reposo en la infraestructura compartida de MeetingBaaS.
Los activos del dashboard permanecen en nuestros buckets. Los logotipos, avatares de usuario y archivos adjuntos de soporte no son datos de reunión y no están cubiertos.
Reversión
DELETE /v2/storage-config, seguro en cualquier momento. Los nuevos bots vuelven a nuestro almacenamiento de inmediato. Los bots existentes siguen resolviendo a sus buckets y siguen funcionando.
- Seis proveedores de transcripción, una sola API — combine la región de un bucket con la región de un proveedor para lograr residencia de extremo a extremo
- Autoalojar Meeting BaaS — si ser dueño del bucket no llega lo suficientemente lejos
- Referencia de la API de Meeting BaaS
Si está trabajando con un requisito de residencia y desea saber exactamente qué componentes tocan qué, contáctenos. Le daremos la misma respuesta que dimos aquí.